行业观察
做工厂视觉质检、移动巡检机器人或者三维重建的工程师,对单目深度估计有一个老大难的体感:用单帧图像模型测出的物体边缘很锐,哪怕细电线也能勾出轮廓,但视频一旦动起来,整张深度图就像油锅里飘的浮沫一样不停闪烁;反过来换用传统多帧视频深度模型,画面是稳住了,机械臂夹爪、细线束和远景交界处却经常糊成一块团。
近期,Apple 机器学习研究团队在论文(arXiv:2611.26603)与 GitHub 开源仓库 apple-aiml-research/ml-depth-pro-2 正式放出 Depth Pro 2,一口气提供了从 24.3M(S) 到 872.1M(H+) 的四档模型,想用同一个网络把单张照片、完整视频和实时摄像头流的“物理米数精度、边缘锐度和跨帧稳定性”一起拉满。我们在公开评测之外,把整套代码与五份官方权重拉进本地,直接用工作站上的 NVIDIA RTX PRO 4000 Blackwell(24 GB 显存) 在 CUDA bfloat16 环境下跑完了四档全分辨率压测、三段实景视频防抖对照与真实坐标采样验证。
一、跨帧注意力是怎么同时拿住“边缘锐”和“画面稳”的
要把这件事看透,不能只听摘要宣传,得直接翻进源码去看它到底改了什么。对比去年底第一代 Depth Pro,Depth Pro 2 在架构上没有给单帧网络外挂一个“事后帧间平滑滤波器”,而是直接在基于 DINOv3 ViT 的主干网络内部,把单帧自注意力和**跨帧注意力(Cross-Frame Attention)**交替拧在了一起,再由 DPT 解码器直接按输入原图分辨率(仅补齐到 32 像素的倍数,不强行压缩成固定低分辨率正方形)吐出带焦距归一化的逆深度图。
翻看开源代码里的模型配置清单,S(24.3M 参数)与 B(96.5M 参数)两档都在 12 层主干网的第 5、7、9、11 层插入了跨帧注意力块;L(334.0M 参数)在 24 层主干里切出了 8 个跨帧交互层;旗舰版 H+(872.1M 参数)则把 32 层里第 11 到 31 层的共 11 个块做成了跨帧通信。离线处理整段视频(buffered 默认模式)时,网络会按 16 帧窗口配合 4 帧重叠往前推进;面对需要立刻出数的实时相机流(unbuffered 模式),它通过 KVCache 环形缓存保留前面最多 15 帧的特征键和值,新帧一到只算当前帧就能看清上下文。
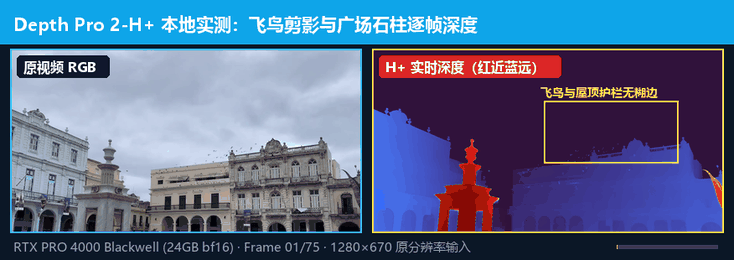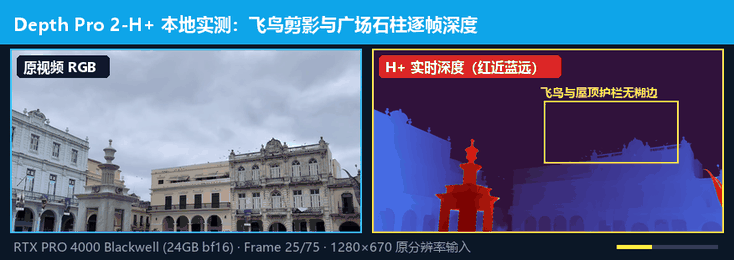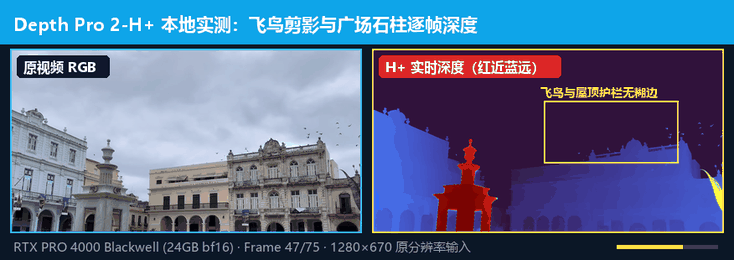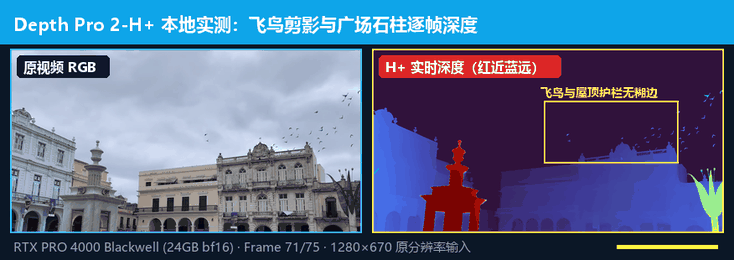
实际把一段 1280×670 的实景广场手持摇镜视频喂给本地 RTX PRO 4000 Blackwell 上的 H+(872.1M),第一观感就是“既没有缩放丢细节,也没有把天上的飞鸟糊掉”。前排石质喷泉柱、中景广场行人、远端巴洛克窗框,乃至高空掠过灰色云层的一只只小鸟剪影,在热力图上全部干净剥离出轮廓,天空区域也准确识别成无穷远(inf)。
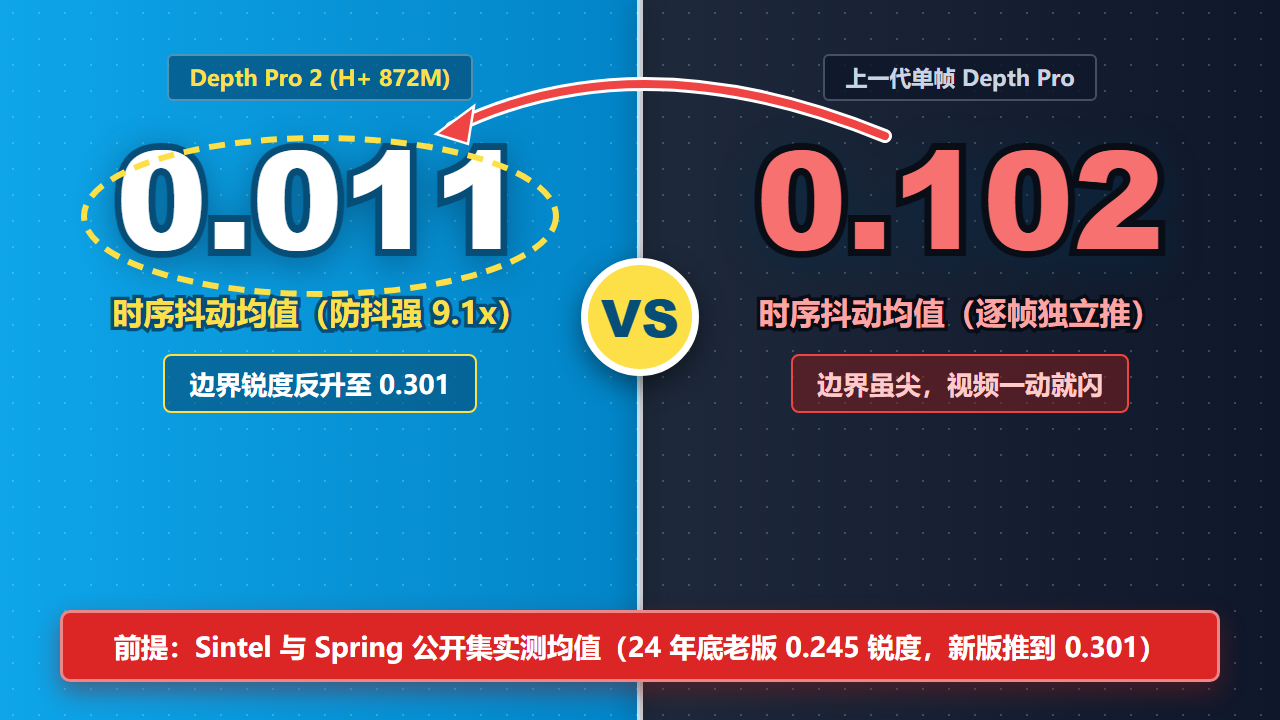
论文里给出了一组跨数据集平均值(Sintel 与 Spring 合成视频均值):上一代单帧 Depth Pro 时序抖动为 0.10171、边界锐度为 0.245,而 Depth Pro 2-H+ 把抖动压低到 0.01117(防抖提升 9.1 倍),同时把边界锐度 Boundary F1 推高到 0.3012。为了核实这套架构在真实连续视频流上的体感到底有多大差别,我们在本地直接用 H+ 对三段不同运动特征的 75 帧 30fps 视频做了对照实测:一组按单帧独立方式(w=1 且每帧重估焦距)跑完,另一组开启默认 16 帧跨帧窗口(buffered, w=16, overlap=4),统计非天空有效像素的逐帧对数逆深度跳变均值(指标越低代表画面越稳)。
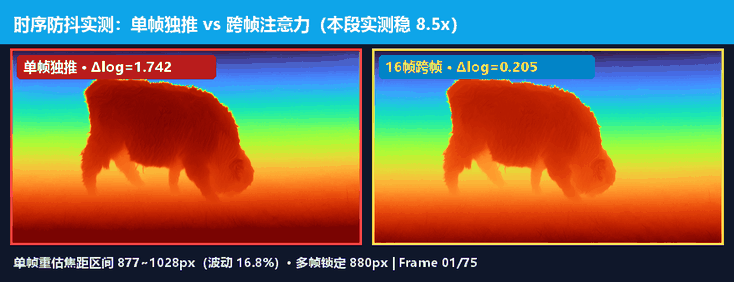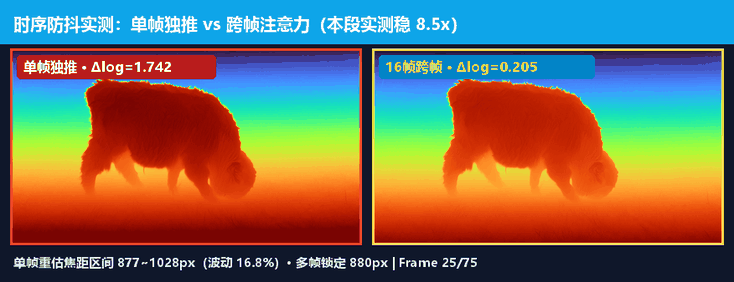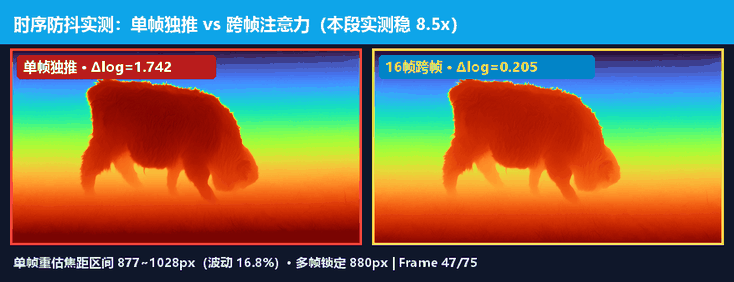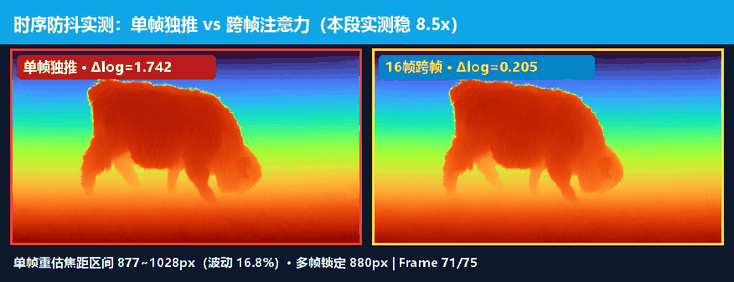
本地对照实测呈现了很直白的数据差距。在毛发细密且背景草皮连续变化的高地牛片段(1280×720)里,单帧独立推理的对数跳变均值测得 1.742(缩放 ×100),开启 16 帧跨帧注意力与统一焦距锁定后测得 0.205,本地实测稳定性整整提升 8.50 倍(即使先锁死同一焦距、单独对比跨帧注意力前后:w=1 锁焦为 0.878,开启跨帧后降至 0.205,仍带来 4.28 倍 的降抖收益);在海岸悬崖灯塔与海鸥片段(1280×720)中,单帧跑出 3.871、16 帧压至 0.808(稳了 4.79 倍);哪怕是镜头大角度摇晃、群鸟满天飞的广场片段(1280×670),单帧跳变 5.165,16 帧压低到 2.347(提升 2.20 倍)。上面的对比动图里能用肉眼直接看到,左边单帧推理下的草地与天空颜色深度都在“呼哧呼哧”随帧呼吸跳变,右边 16 帧模式却稳稳钉在同一套物理尺度上。
二、24G 独显跑完 4 档全尺寸:边缘和速度怎么选才不翻车
既然官方一下子放出 S、B、L、H+ 四个尺寸、权重体积从 97 MB 一直跨到 3.5 GB(外加所有模型共用的 94 MB 视场角焦距估计器 fov),工程落地最实际的问题就是:小模型到底糊多少,大模型在一块主流工作站 24G 独显上又会慢到什么程度?
我们先把同一组复杂边缘样张(高地牛长毛剪影、工业机械臂垂挂细线束、广场飞鸟窗格)逐一喂给四档模型(全在 CUDA bfloat16 自动混合精度下先预热一帧再计时)。放大看切片对比,档位之间的边界能力断层几乎是一目了然的:最轻的 S(24.3M)在高地牛背部明显带出一圈“土豆泥”般的平滑晕边,部分线束分叉处互相黏连;升到 B(96.5M)后,机械臂卡爪镂空和较粗传感器线缆拉直了;而一旦跨上 L(334.0M)和 H+(872.1M),连高地牛背上蓬松的卷曲杂毛、甚至机械臂线束最底端那两根几像素宽的扎带散线尾梢,都像刻刀抠图一样一根根分了出来(720p 单张预热后推理耗时:S 为 35.4 到 62.0 ms,B 为 57.6 到 69.7 ms,L 为 116.1 到 149.7 ms,H+ 为 203.2 到 265.0 ms)。
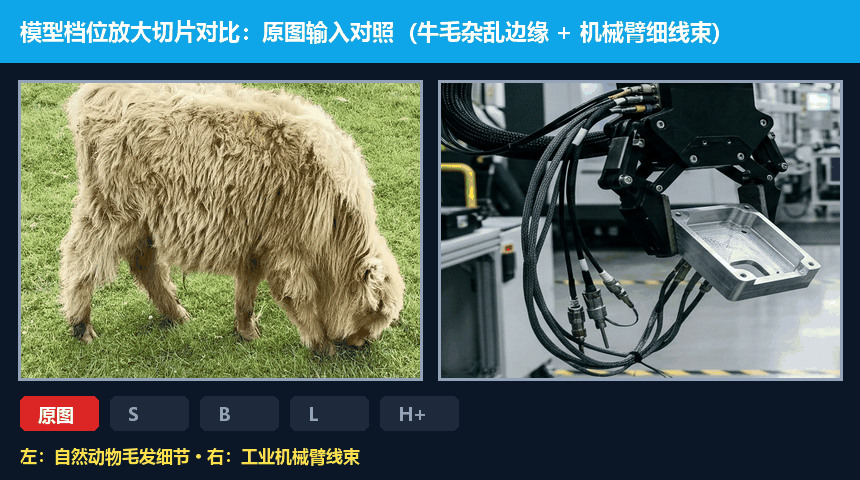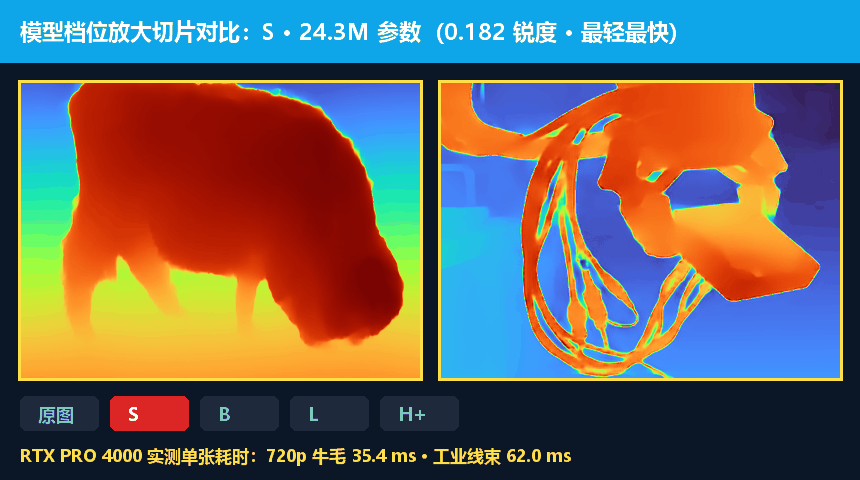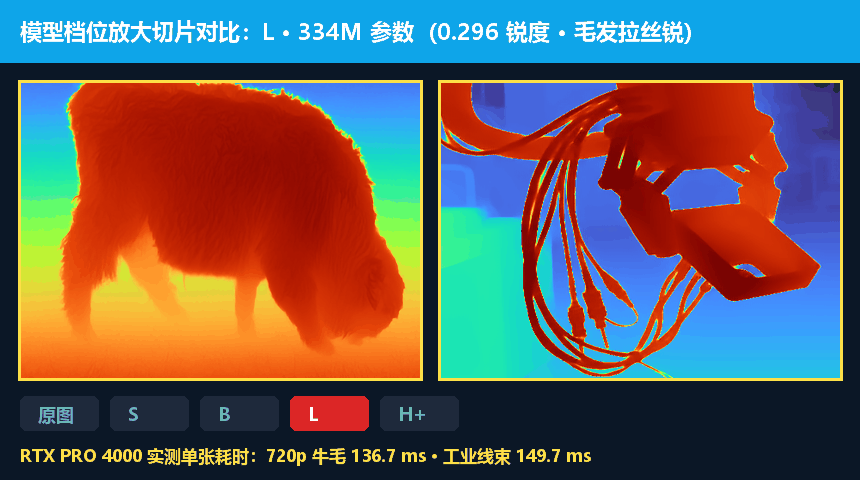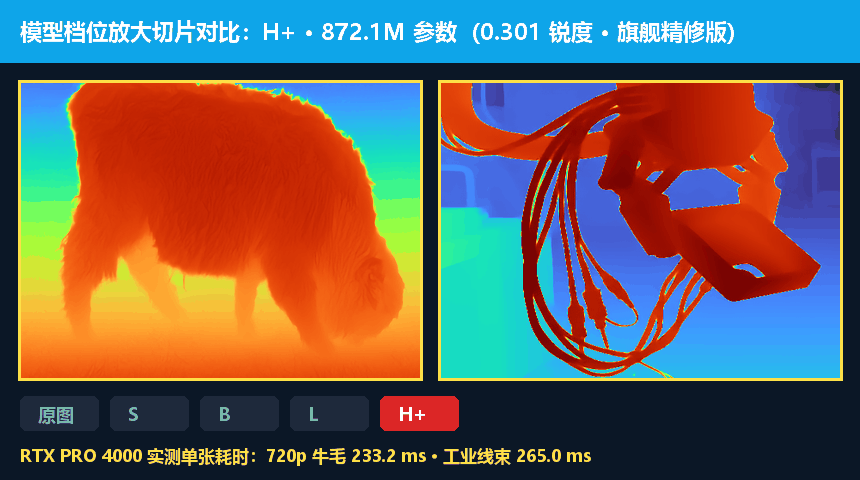
紧接着我们在同一块 NVIDIA RTX PRO 4000 Blackwell(23.87 GB 可用显存,PyTorch 2.11.0+cu128) 上,把四档模型横跨 360p / 480p / 720p / 1080p 四个分辨率、三种推理方式(实时单帧 unbuf w=1、实时流 4 帧缓存 unbuf w=4、离线批处理 buf w=16/overlap=4)共 48 种组合 全部跑了一遍,统计同步后的中位单帧耗时、帧率以及 CUDA 峰值保留显存。
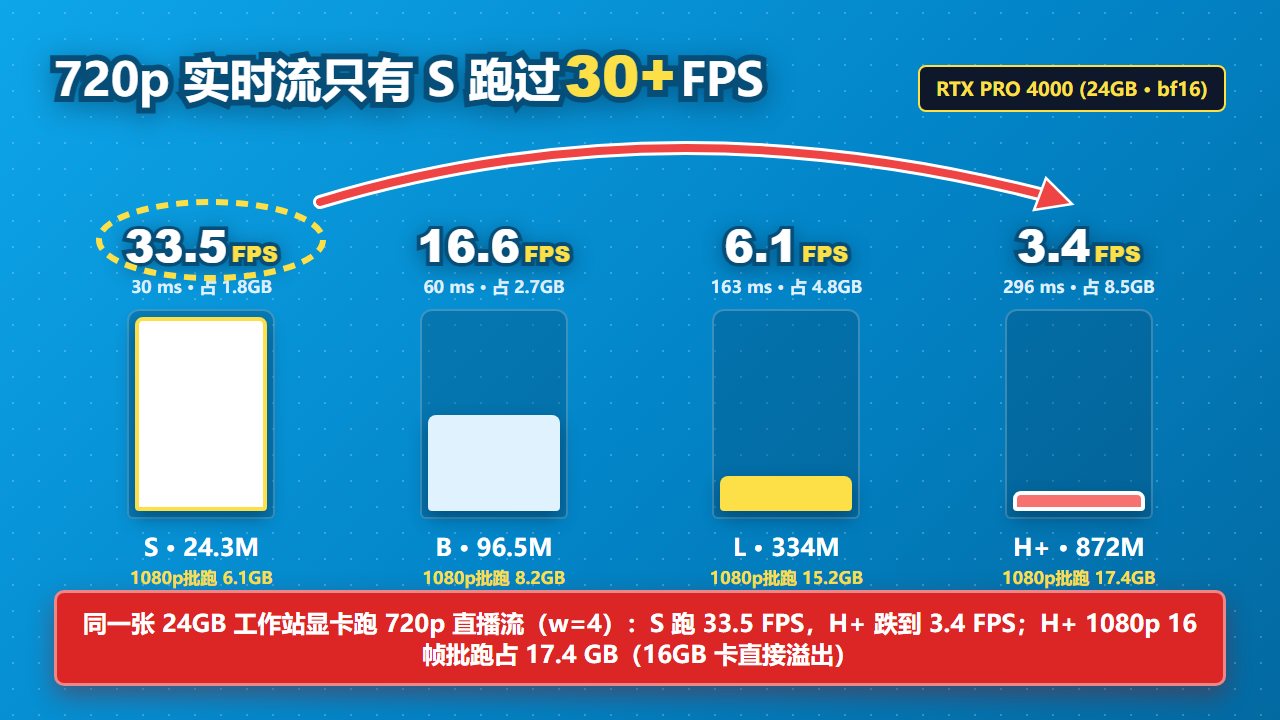
跑完这 48 组数后,产线选型的账一下子就清晰了。如果业务盯着“实时相机 30 FPS 绿线”不放:在 480p(854×480)实时流(w=4) 下,S 能冲到 53.6 FPS(18.7 ms/帧,1.51 GiB 显存)、B 能稳跑 43.0 FPS(23.2 ms/帧,1.51 GiB),L 则掉到 16.8 FPS(59.4 ms/帧)、H+ 只剩 9.7 FPS(103.5 ms/帧);如果分辨率拉到工业相机会用的 720p(1280×720)实时流(w=4),整套家族里就只有最轻的 S 守住了 30 帧门槛(33.5 FPS,29.9 ms/帧,1.81 GiB 显存),B 直接掉半截剩 16.6 FPS(60.4 ms/帧,2.70 GiB),L 只有 6.1 FPS(163.4 ms/帧,4.83 GiB),而旗舰 H+ 每帧要啃掉 295.7 ms(仅 3.4 FPS,占 8.46 GiB 显存)。
到了 1080p(1920×1080)全高清默认离线批处理(buffered w=16, overlap=4),算力和显存直接亮出陡峭的崖壁:S 退到 4.0 FPS(247.5 ms/帧,6.10 GiB),L 慢成每帧 1.38 秒(0.73 FPS,15.18 GiB),旗舰 H+ 在 24 GB 工作站卡上勉强扛住没崩,但单帧耗时高达 2,369.6 ms(0.42 FPS),峰值保留显存冲到 17.40 GiB(已分配 16.55 GiB)。换句话说,市面上大量 16 GB 显存的消费级显卡和移动工作站笔记本,一跑 1080p 默认 16 帧批处理就会直接在显存门口爆掉(Apple 官方 Mac 实测文档同样提醒:1280×720 下用 Core ML 跑 L -w 4 就占满约 18 GB 内存且只跑出 1 FPS,16 GB MacBook Pro 只能停留在 S 或 B)。
三、工位与实景测距验证:焦距偏 10%,全图米数跟着偏 10%
把模型从“拍个热力图好看”推到“算准工位距离几米几厘米”,有两处文档和代码里专门写死的物理陷阱最容易坑到人。
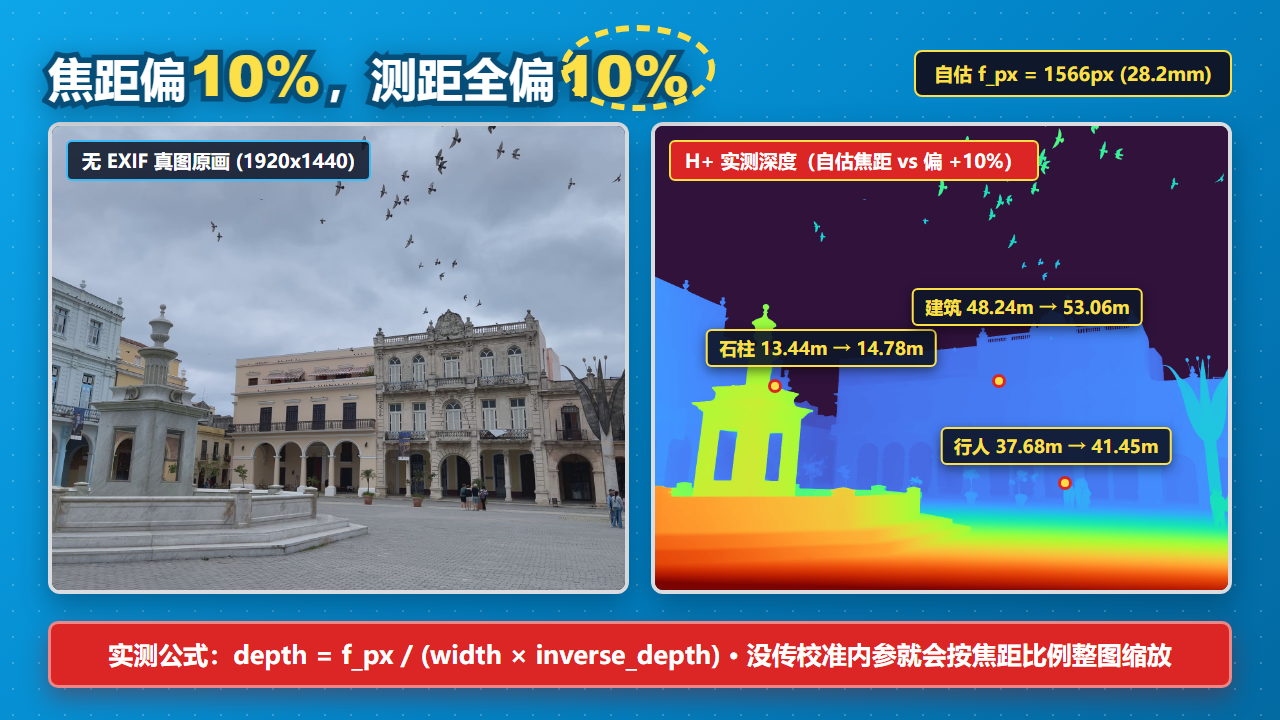
第一处是数值定义本身。官方输出 .npz 文件里存的 depth,严格意义上是相机光轴 Z 方向的正交深度距离(平面投影距离),而不是相机光心到物体表面的斜线欧氏距离;要把单个像素换算成真实米数,底层公式是 depth = f_px / (width × inverse_depth)。这也就解释了为什么必须先看清输入图像到底有没有焦距信息:如果照片本身带 EXIF 35mm 等效焦距,代码会直接跳开焦距估计网络做换算;如果没有 EXIF(视频文件更是全都没有),网络就靠一个 94 MB 的独立 FOVEstimator 去反推画面视场角,并且只用视频第一组窗口各帧估算出的中位焦距锁死整条视频。
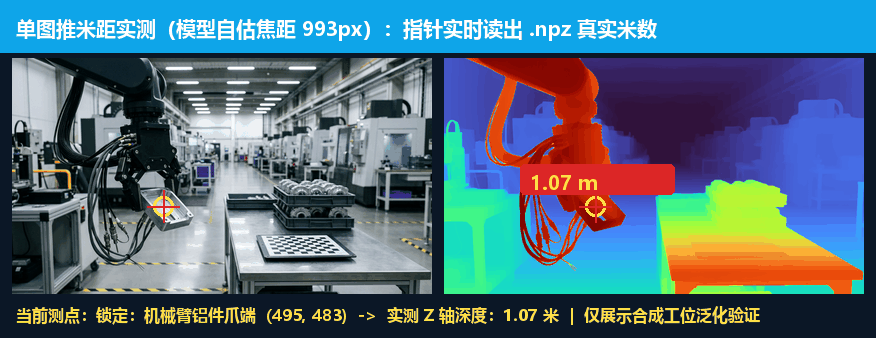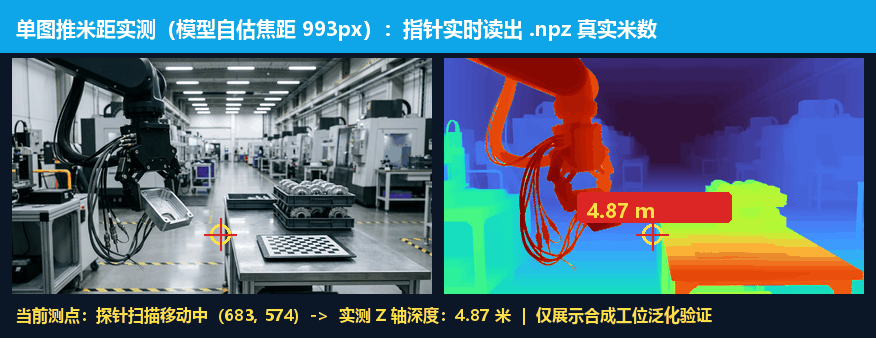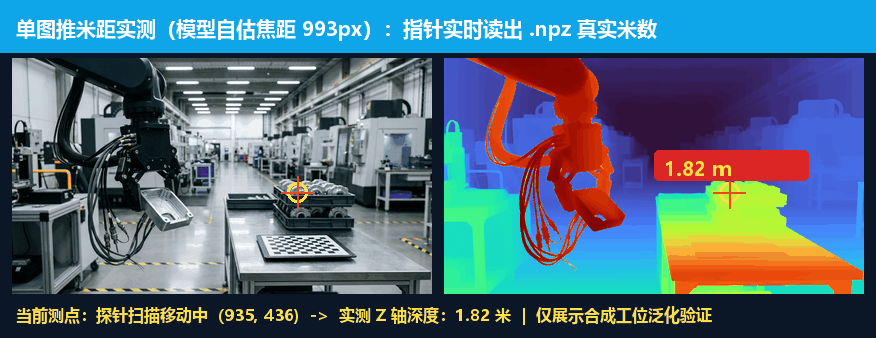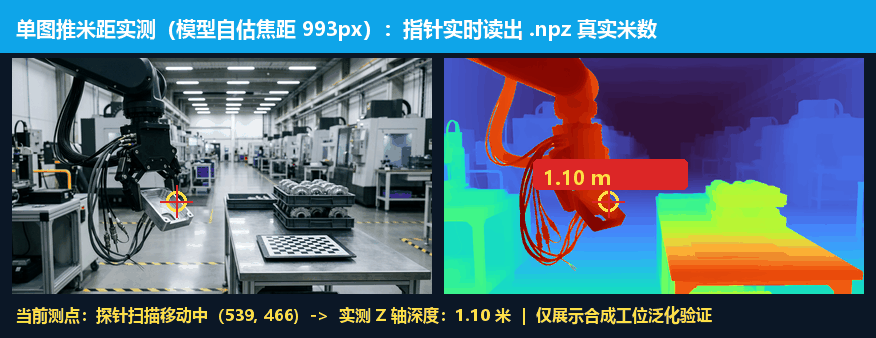
我们先用一张自建合成的制造工位检验图(六轴工业机械臂夹爪悬持铝制支架与多股黑色传感器线束、中景不锈钢台车与标定棋盘格、远景纵深 CNC 加工中心通道)喂给 H+ 做几何边缘与连续尺度泛化测试,模型自估像素焦距 993.0 px(约等效 27.3 mm 镜头),从 .npz 矩阵里实测读出的各点深度层次非常分明:机械臂最前垂挂细线束接头 0.93 米,铝制夹爪与工件端 1.07 米,不锈钢台面棋盘格 1.43 米,后方层叠齿轮料盘 1.81 米,纵深通道远端设备 13.26 米。
紧接着我们把真实无 EXIF 的广场照片(1920×1440,example.jpg)放进对照实验:模型自动反推出等效 28.2 mm 镜头的 1566.0 px 焦距,实测前排喷泉石柱 13.44 米、中景游客 37.68 米、背景拱门建筑 48.24 米;此时如果把传入的 f_px 人为加偏 10%,整张图每个像素的距离读数瞬间同比例整体漂偏 10%(石柱变成 14.78 米、游客变成 41.45 米、建筑变成 53.06 米)。回头再看前面那三段 75 帧实测视频里“单帧每帧重估焦距”的记录就更触目惊心:高地牛与广场摇镜片段里,单帧 FOVEstimator 逐帧瞎猜出的焦距极差摆动幅度分别达到 16.8% 和 19.24%!虽然官方对比实验里新版视场角估计器的 25% 误差内命中率已经从上一代 71.7% 拉高到 88.6%,但对于产线机械臂抓取、AGV 避障这种厘米级刚性场景,只要镜头不先做离线标定把内参 f_px 写死传进去,全自动测出的米数就会顺着镜头视角一起漂。另外实测中也看到,天空区域 H+ 会干净输出 inf,而工程部署做点云切片或障碍物聚类前必须先把远端无穷大与过远噪点截断,否则极小模型给出的数公里幻觉值会直接拉爆三维包围盒。
四、制造研发团队想往工程里接,先把这三条硬边界看清
很多做视觉设备、工业相机和具身智能的老板或技术总监,看到开源仓库地址和这么锐的边缘动图,第一念头就是明天让算法团队把权重直接包进测试机上产线。正式拍板立项前,有三条底线比模型跑多少帧重要得多。
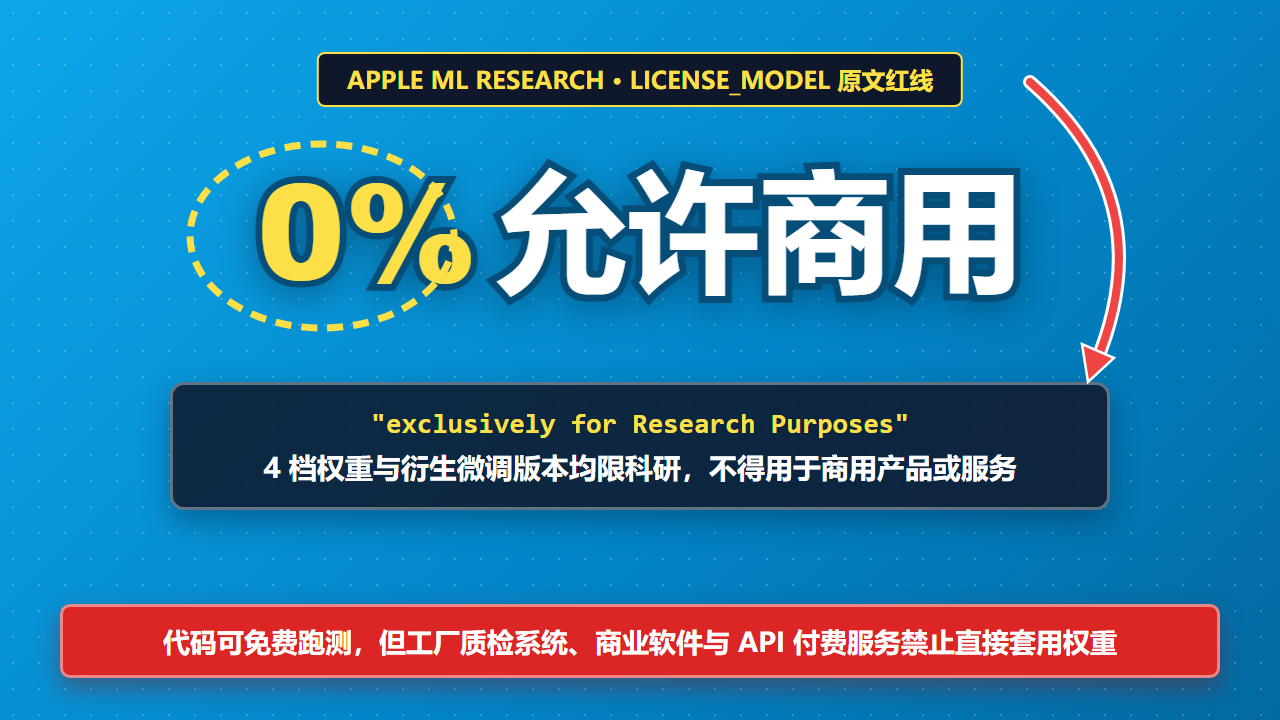
第一条边界最硬,看协议不看跑分。Depth Pro 2 只有外围推理代码开源,四个尺寸的模型权重全部签在 Apple 专用的 LICENSE_MODEL 之下,协议正文白纸黑字写死权重及一切衍生微调版本(Model Derivatives)“仅限科研用途(exclusively for Research Purposes)”,明确排除了任何商业开发、付费 API 服务、产品集成或商业产线质检交付。拿它当学术基准、造数据辅助标注或者做科研型合成校验可以;如果公司主业是卖视觉质检软件或机器人控制器方案给下游主机厂,直接把官方权重(甚至基于它微调出的权重)打包出货,合规红线一踩就翻。
第二条边界看分辨率与节拍预算。如果确实要跑在科研实验台或内部模拟仿真流水线上,别迷信 H+ 的旗舰标签:在 24 GB 工作站显卡上,720p 实时流只有 S(33.5 FPS)能喂饱常规 30Hz 工业相机,想兼顾细线边缘和能接受的帧率,480p 跑 B(43.0 FPS)或 720p 降低采样率跑 B(16.6 FPS)配短 window 窗口 才是现实的甜区。直接用默认 H+ 硬跑 1080p 视频,两秒多出一帧的节奏只适合离线算真值底图,而且一旦把多帧窗口开齐,16 GB 消费级显卡随时撞墙溢出。
第三条边界,是写春秋管理咨询在拆解制造企业硬科技研发项目时最常看到的管理盲区:千万别拿着“开箱效果很惊艳的研究级开源模型”,去省掉“工程底座建设”的笨功夫。就像这次实测显露出来的规律,真正卡死一个机器视觉项目能不能干活的,往往不是主干网参数从 3 亿堆到 8 亿,而是团队有没有把相机标定内参、工作距离精度兜底、帧率节拍门禁和合规商用许可在第一天立项前算清楚。写春秋一直建议硬件和制造企业的研发负责人,面对这种顶刊级开源突破,最划算的动作不是急着追新替换现场传感器,而是第一时间拿它当“免费合成基准线”和“内部评测尺子”,测清楚自家自研小模型或标定双目相机的真实边界还差几分,再决定到底花钱补工程化还是补硬件。
信息整理与技术评测说明:本文涉及模型原理、架构与公开集数据引用自 Apple 机器学习研究团队公开论文(arXiv:2611.26603)及官方仓库 apple-aiml-research/ml-depth-pro-2 公开资料与 LICENSE_MODEL 协议;所有本地速度、显存占用、焦距偏移与逐帧稳定度数据均实测于 NVIDIA RTX PRO 4000 Blackwell(24 GB 显存、PyTorch 2.11.0+cu128、bfloat16 自动混合精度),其中机械臂工位图像仅作合成场景泛化测试,本文为客观技术评测,不构成商业采购或工程验收依据。
常见问题
Depth Pro 2 相比上一代单帧 Depth Pro,核心变化和实测防抖幅度有多大?
Depth Pro 2 没有采用事后帧间平滑滤波,而是在 DINOv3 ViT 主干内部交替嵌入单帧自注意力与跨帧注意力(Cross-Frame Attention),离线模式默认按 16 帧窗口与 4 帧重叠推进,实时流模式通过 KVCache 缓存最近最多 15 帧上下文。论文公开集均值时序抖动由 0.10171 降至 0.01117(防抖提升 9.1 倍),Boundary F1 升至 0.3012;我们在本地 RTX PRO 4000 Blackwell 上用 H+ 实测三段 75 帧实景视频,高地牛片段由 1.742 降至 0.205(稳定性提升 8.50 倍),海岸灯塔提升 4.79 倍,广场飞鸟提升 2.20 倍。
在 24 GB 工作站显卡上,S、B、L、H+ 四档模型跑实时流和 1080p 视频分别是什么表现?
在 NVIDIA RTX PRO 4000 Blackwell(23.87 GB 可用显存,bfloat16)48 组压测中:480p 实时流(w=4)下 S 可跑 53.6 FPS、B 可跑 43.0 FPS;720p 实时流(w=4)下仅 S 守住 30 帧线(33.5 FPS,1.81 GiB 显存),B 为 16.6 FPS(2.70 GiB),L 为 6.1 FPS(4.83 GiB),H+ 为 3.4 FPS(8.46 GiB);而在 1080p 默认 16 帧离线批处理下,H+ 单帧耗时 2,369.6 ms(0.42 FPS),峰值保留显存冲到 17.40 GiB,常规 16 GB 消费级显卡会直接溢出。
用 Depth Pro 2 做机器人抓取或工位测距时,为什么焦距标定非常关键?
官方 .npz 输出的是沿相机光轴 Z 方向的正交深度(depth = f_px / (width × inverse_depth))。在无 EXIF 实拍广场图对照实验中,只要将像素焦距 f_px 人为加偏 10%,全图所有物体的实测米数就会同比例漂偏 10%(石柱从 13.44 米变为 14.78 米,中景游客从 37.68 米变为 41.45 米)。在厘米级工业抓取或 AGV 避障场景中,必须离线标定并显式传入固定相机内参,不能直接依赖无标定自动焦距反推。
制造企业或视觉软件公司能直接把 Depth Pro 2 的官方权重打包进商业产品交付吗?
不能。Depth Pro 2 仅外围推理代码开源,S、B、L、H+ 四个尺寸的权重文件均签在 Apple 专用的 LICENSE_MODEL 协议之下,明确规定权重及其微调衍生版本仅限科研用途(exclusively for Research Purposes),禁止任何商业开发、付费 API、商业软件集成或产线商业交付。写春秋管理咨询建议研发团队将其作为内部评测基准尺子或科研对照基线,避免在合规红线上返工。
写春秋管理咨询 · 顾问直连(自 2005)
扫码领《同行业人效数据表 / 咨询签约核查单》
微信扫码添加写春秋顾问企业微信,发送「核查单」即可领取本文配套工具表。如企业已有明确改善计划,请直接留言「所在城市 + 行业 + 人数 + 当前卡点」,资深顾问本人对接。
自测工具: 97 家企业人效对标计算器 · 计件改计效与调薪保本测算 · 人效分位与咨询选型对照表
首席顾问:刘新珍(国防科大工程师出身 · 中国首位女性 ICMC 认证咨询师 · 20余年管理咨询经验) · 地址:深圳市光明区招商局光明科技园 B2-1402