行业观察
2026 年 11 月 18 日,Google DeepMind 正式放出 Gemini 4 Neon。原本业内以为这只是旗舰系列里的一次常规中档更新,结果五份第三方实测榜单同步出炉后,整个硅谷算力圈瞬间坐不住了。
真正让同行倒吸一口凉气的,并不是 Neon 又把某项基准刷高了零点几个点,而是它把前沿智能的价格和延迟同时打穿了。
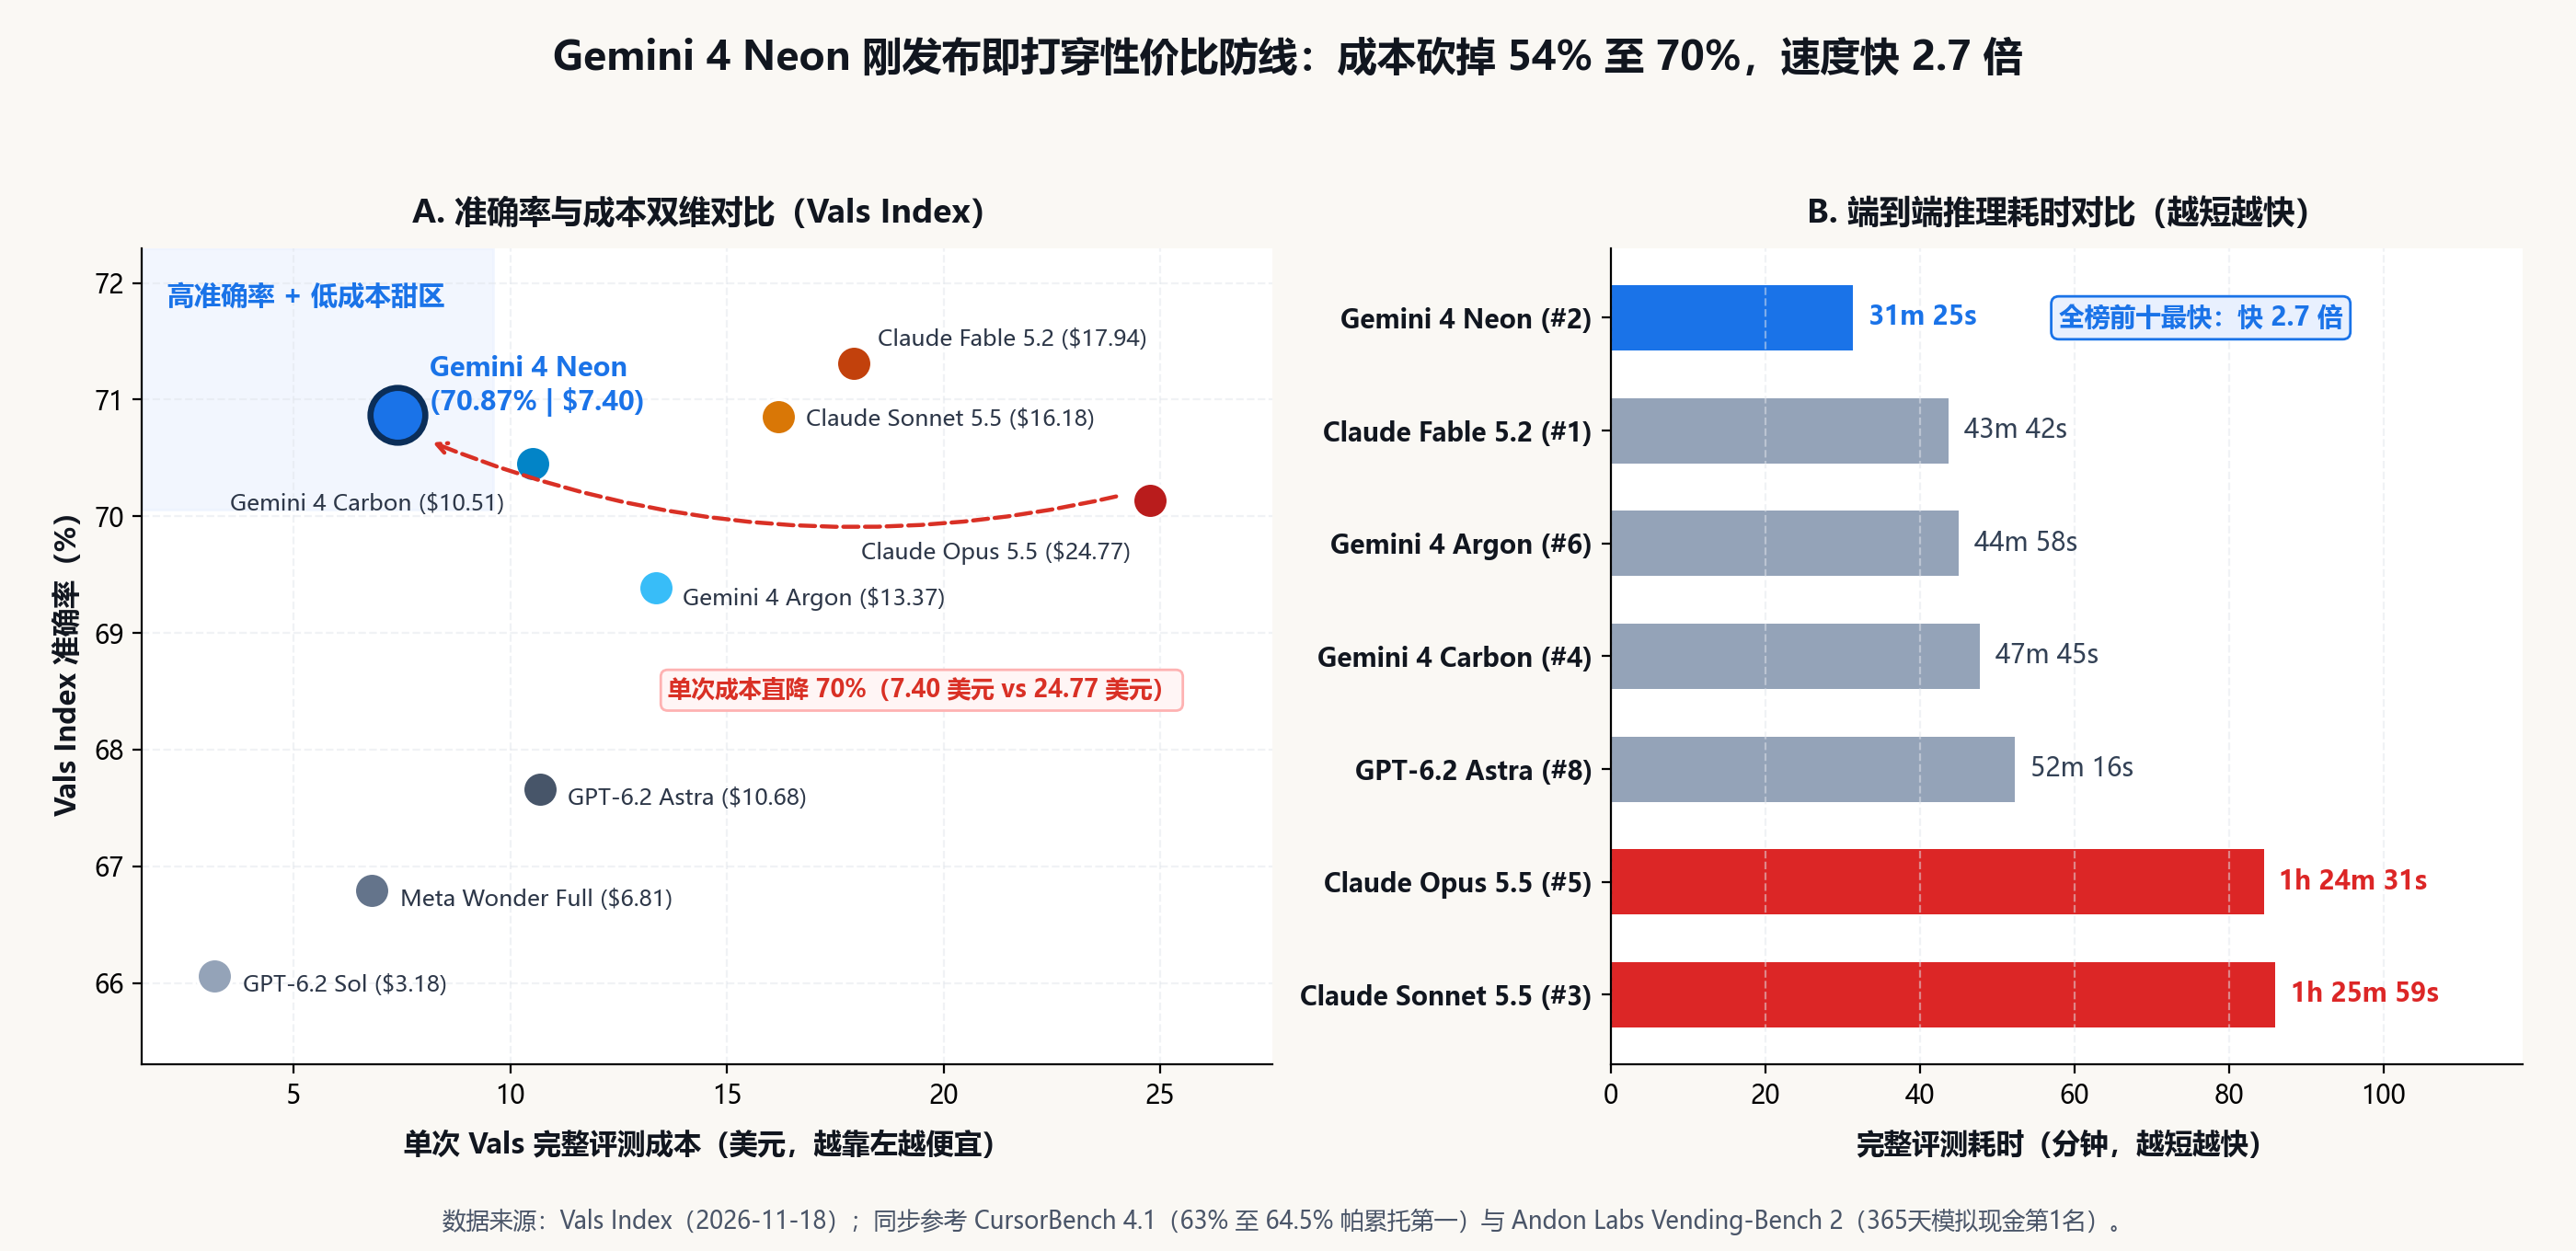
在 11 月 18 日最新一期 Vals Index 榜单上,Gemini 4 Neon 以 70.87% 的准确率冲上全球第 2,距离第 1 名 Claude Fable 5.2(71.31%)仅仅差了 0.44 个百分点。但往右看两列,账本画风突变:
- 单次评测成本:Claude Fable 5.2 要花 17.94 美元,Claude Sonnet 5.5 要 16.18 美元,Claude Opus 5.5 高达 24.77 美元;而 Gemini 4 Neon 只要 7.40 美元,直接比同级对手便宜了 54% 到 70%。
- 完成耗时:Opus 5.5 和 Sonnet 5.5 都要跑 1 小时 25 分钟左右,Fable 5.2 要 43 分 42 秒,Gemini 4 Neon 只用了 31 分 25 秒,稳居全榜前十最快,比前两者快了足足 2.7 倍。
2 分钟硬核视频拆解: 结合 Vals Index 与 SemiAnalysis 实测账本,全景复盘 Google 十年自研 TPU v7 Ironwood 如何把旗舰推理成本砍半。
同样的压制也出现在另外几份硬核评测里:在 CursorBench 4.1 编程智能体测试中,Gemini 4 Neon 独自挂在最右上方的帕累托前沿,以每任务约 6.5 至 10.5 美元的价格跑到 63% 至 64.5% 得分,把单任务接近 18 美元才拿到约 58% 的竞品远远甩在后面;在模拟 365 天自主商业运营的 Andon Labs Vending-Bench 2 中,Neon 一举登顶第 1,账面现金冲到约 1.65 万至 1.7 万美元,反超 GPT-6 Astra 和 Claude Opus 5;其官方 API 标准定价也直接压到输入 3 美元、输出 15 美元每百万 Token,缓存输入更是低至 0.15 美元(打 0.5 折)。
大模型研发早已没有秘密武器,大家都在用相似的 MoE 架构、强化学习后训练和海量合成数据。那为什么同样冲到全球前二的能力,偏偏 Google 敢把旗舰推理价格直接腰斩,还能越跑越快?
答案不在模型权重文件里,而藏在 Google 机房的地板下面:一套被它死磕了整整十年的自研芯片体系 TPU(Tensor Processing Unit)。别人每吐出一个 Token 都在替芯片巨头交高额硬件溢价,而 Google 已经把底层算力税彻底拆掉了。
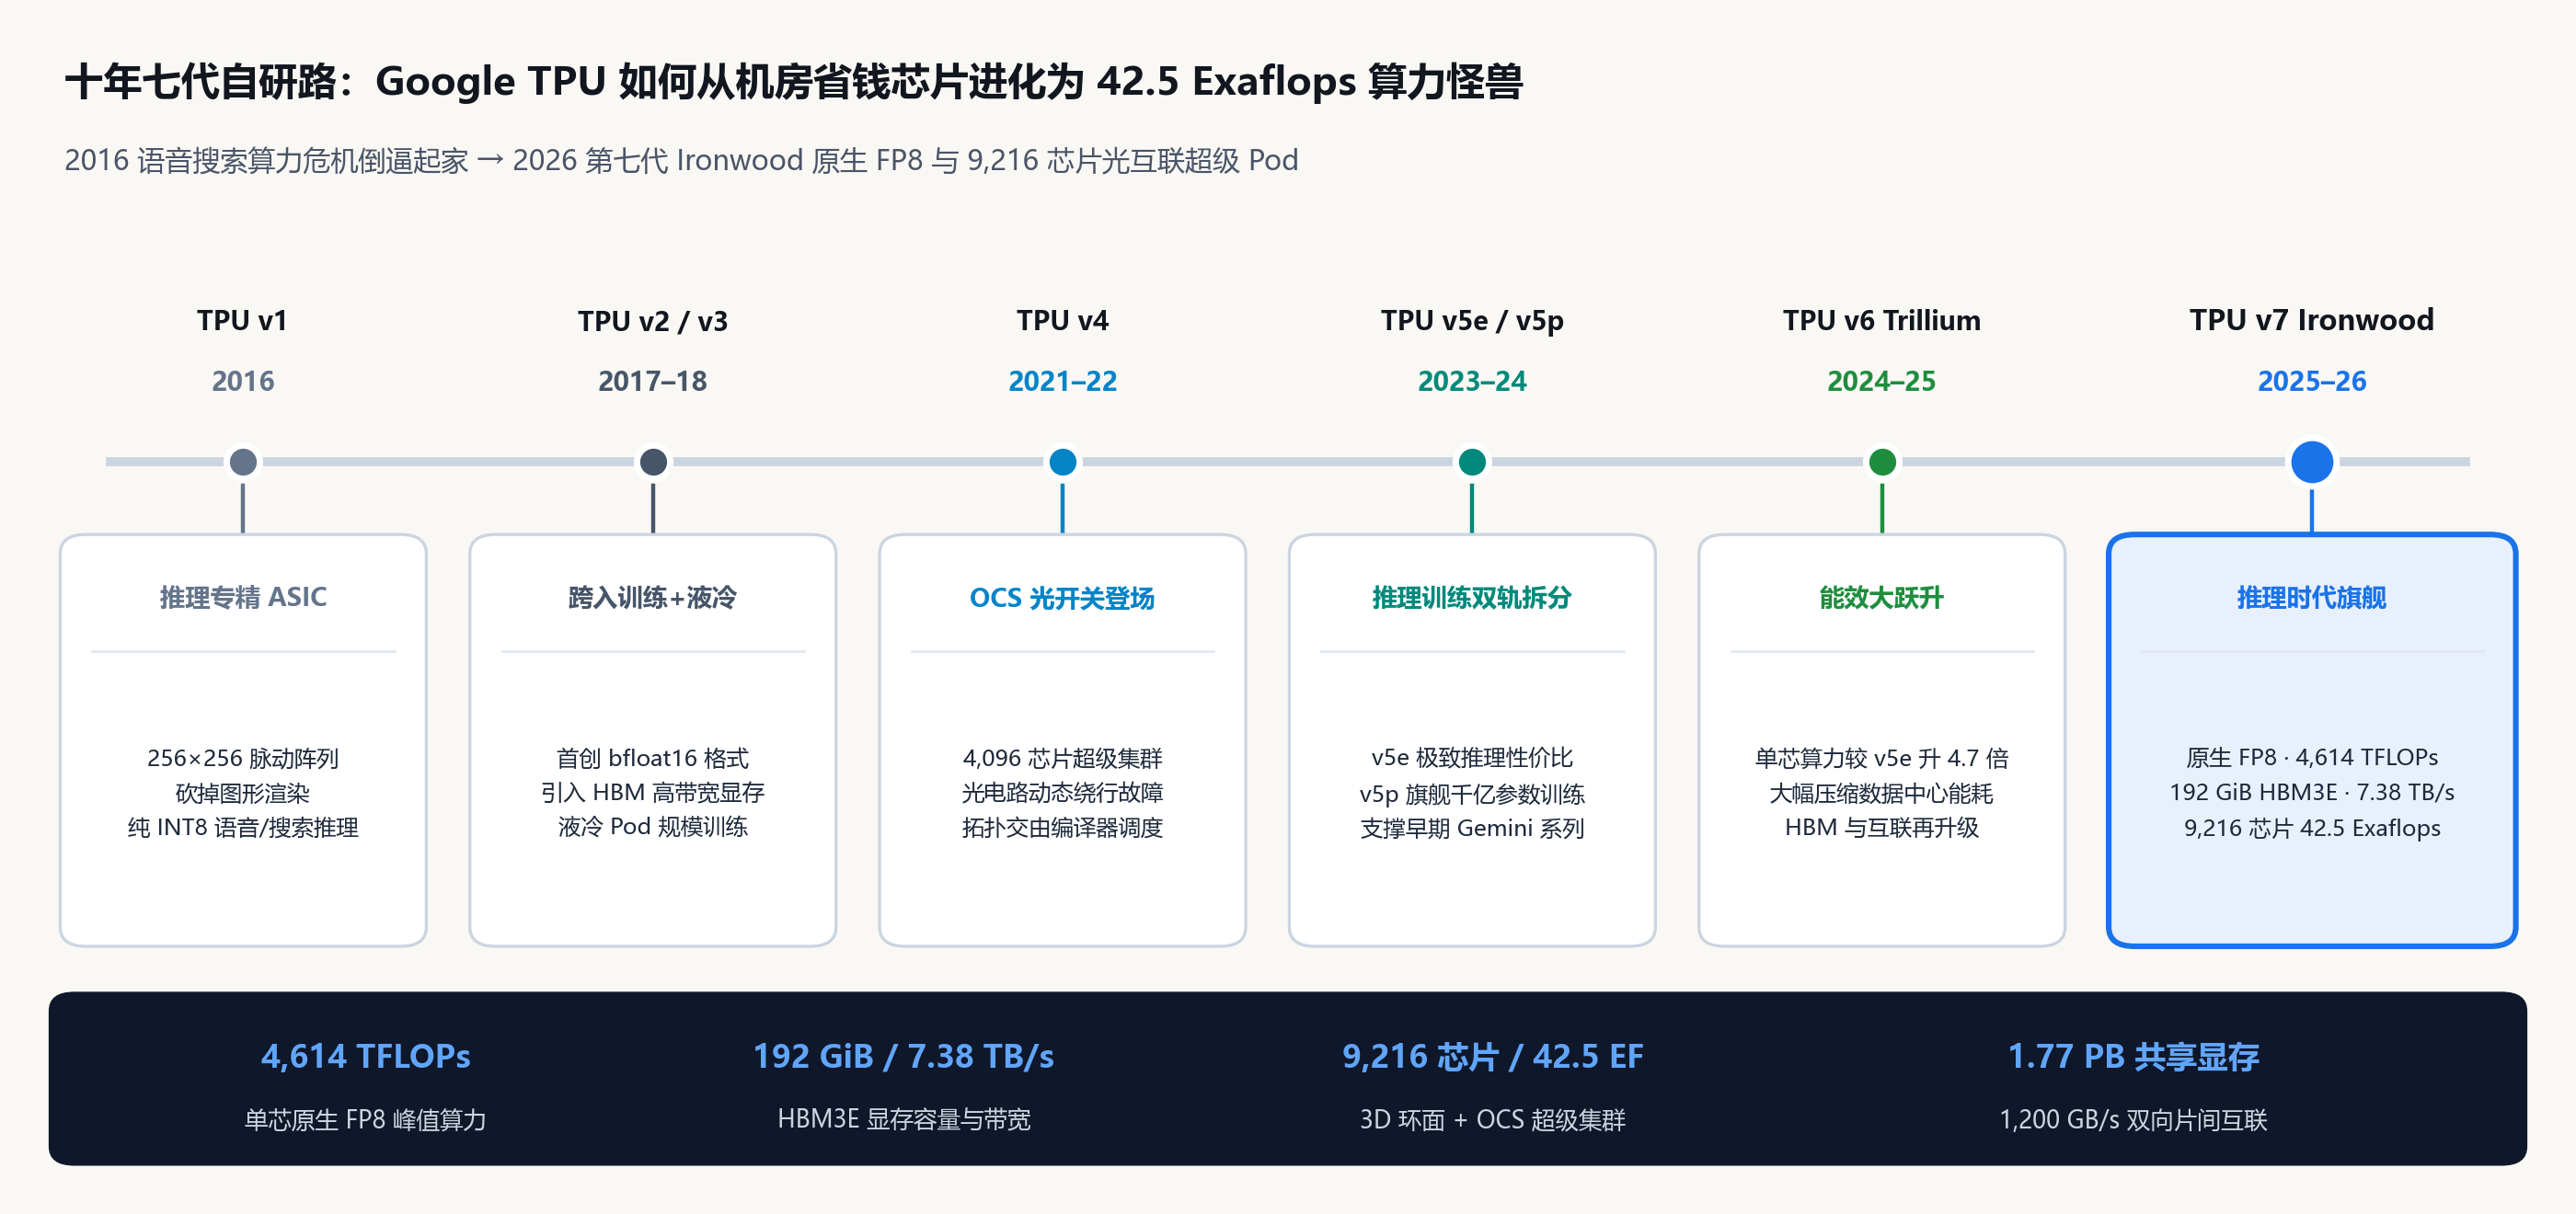
一、2016 年被算力账单逼出的“笨功夫”:十年七代演进
今天回看 Google 自研 TPU,很多人会觉得是一场极具远见的先手棋。但翻回十年前的起点,它其实是 Google 被一份吓人的机房预算单逼出来的自救行动。
2013 年前后,Google 内部做过一次极端测算:如果全球安卓用户每天只用 3 分钟基于深度神经网络的语音搜索,按当时通用 CPU 和显卡的计算效率,Google 光是撑住这一个功能,就需要把全球所有数据中心的规模直接翻倍。买不到足够便宜的卡,电费和基建账单更是无底洞。
与其把命门交给外部供应商,Google 干脆组建团队从零画专用芯片(ASIC),并在 2016 年正式公开第一代 TPU v1。它的思路极其克制:把通用 GPU 上用来做图形渲染、复杂分支预测的晶体管全部砍掉,把芯片面积集中堆给一个 256×256 的脉动阵列(Systolic Array),专职做神经网络最核心的 INT8 矩阵乘加运算。
这第一步看似“笨重”,却帮 Google 打开了一条完全不同于英伟达通用 GPU 的演化路线:
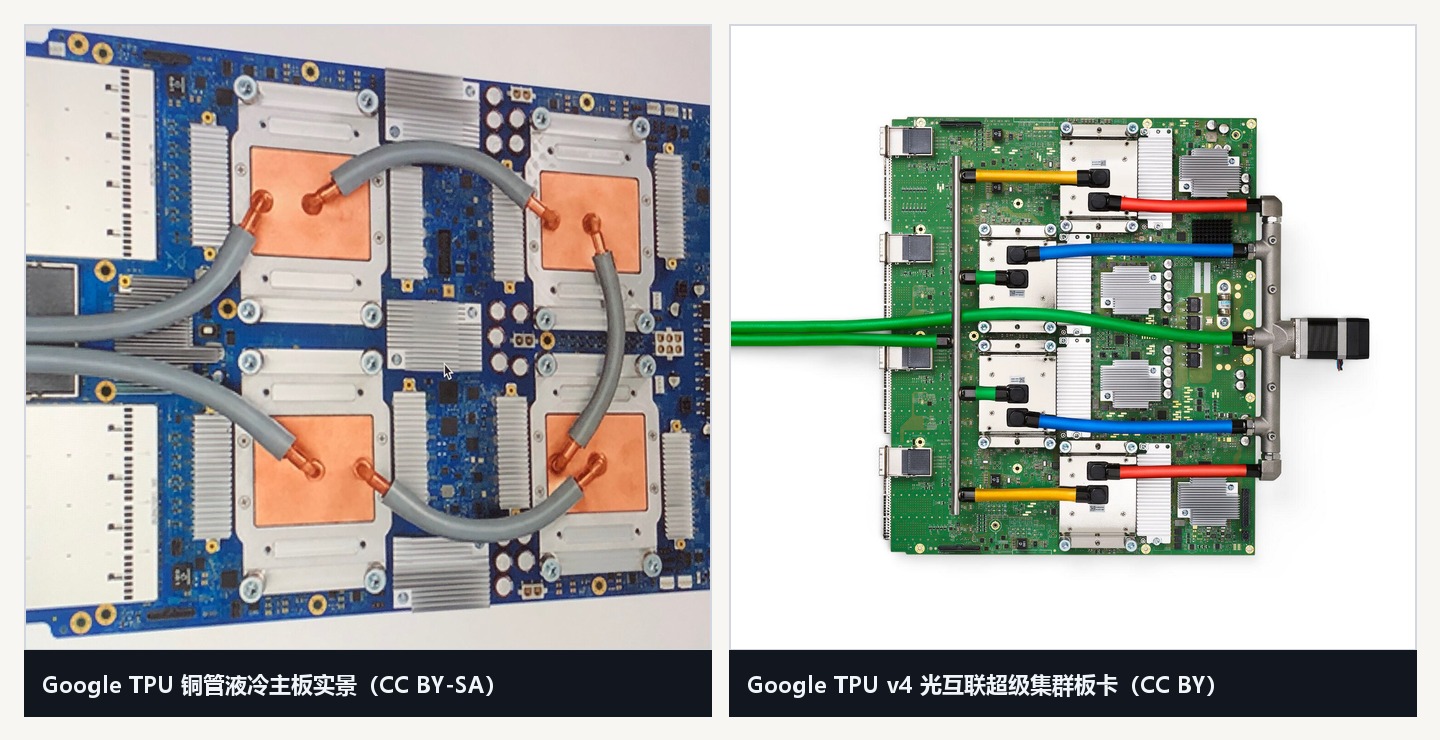
- 2017 至 2018 年(TPU v2 / v3):引入专为深度学习设计的 bfloat16 数据格式、高带宽显存(HBM)和液冷机柜,从纯推理正式跨入大规模训练,奠定了后来 Transformer 与大语言模型的基础设施底座。
- 2021 至 2022 年(TPU v4):把 光电路交换机(OCS) 直接焊进 4,096 颗芯片的超级集群。网络拓扑第一次变成编译器可动态调度的资源,哪颗芯片故障或哪个训练任务需要切分,光路可以直接毫秒级绕行重组,不再因为单点故障拖垮整座集群。
- 2023 至 2024 年(TPU v5e / v5p 与 v6e Trillium):芯片线明确分成“性价比推理”与“极限训练”双轨;第六代 Trillium 把能效和单芯吞吐较 v5e 拉升 4.7 倍。
- 2025 至 2026 年(第七代 TPU v7 Ironwood):十年积累在推理时代迎来总爆发。这是 Google 第一代真正面向大规模前沿推理与对外商业化设计的重型 TPU。
二、拆解第七代 TPU v7 Ironwood:专为“大模型推理经济学”设计的怪兽
过去两年,AI 行业的算力重心发生了彻底反转。预训练只烧一次钱,真正每天 24 小时吞掉数亿美元电费和折旧费的,是动辄几十万字上下文、多轮工具调用、深度思考(Reasoning)的推理与智能体(Agent)工作流。
推理阶段最卡脖子的往往不是算得不够快,而是显存容量不够装权重与 KV Cache、显存带宽喂不饱计算单元、多卡通信延迟太高。Google 与博通(Broadcom)联合落地的第七代 TPU v7(代号 Ironwood),每一项关键参数都精准切在推理瓶颈上:
- 双计算裸片加原生 FP8 翻倍:Ironwood 放弃了前代的 MegaCore 合并逻辑,在一颗封装内放入两个独立计算裸片,首次提供原生 FP8 硬件支持。单芯片 BF16 算力达 2,307 TFLOPs,FP8 峰值算力直接翻倍到 4,614 TFLOPs,还配备 2 颗 TensorCore 与 4 颗专门加速稀疏嵌入查表的第三代 SparseCore。
- 显存与带宽直接拉满:单颗芯片塞进 192 GiB HBM3E 高带宽显存(是上一代 Trillium 的 6 倍、v5p 的 2 倍),内存带宽飙升至 7,380 GB/s(7.38 TB/s)。更大的单芯显存意味着部署数千亿参数 MoE 模型和超长上下文缓存时,跨卡切分更少、吞吐更稳。
- 9,216 颗芯片织成一张 3D 环面光网:每颗 Ironwood 具备 1,200 GB/s 双向片间互联(ICI)带宽,以 4×4×4 的 64 芯片立方体为基本单元,借助 Google 独有的 OCS 光电路交换机向上扩展至 9,216 颗芯片的单一超级 Pod,整座集群聚合出 42.5 Exaflops(FP8) 算力和高达 1.77 PB 的低延迟共享高带宽显存池。
三、算一笔最硬的账:Ironwood 对比英伟达 B200 / B300,每美元多榨出多少 Token?
纸面峰值算力从来不等于真实利润。真正决定一家大模型公司能不能像 Gemini 4 Neon 这样打价格战的,是实际跑开源前沿模型时的单位 Token 成本(TCO)。
芯片与算力独立研究机构 SemiAnalysis 通过自建的开源基准平台 InferenceX 与面向多轮智能体长上下文的 AgentX,把 Google TPU v7 Ironwood 与 NVIDIA Blackwell 架构(B200、B300 等)拉到同一条起跑线上做了实测:
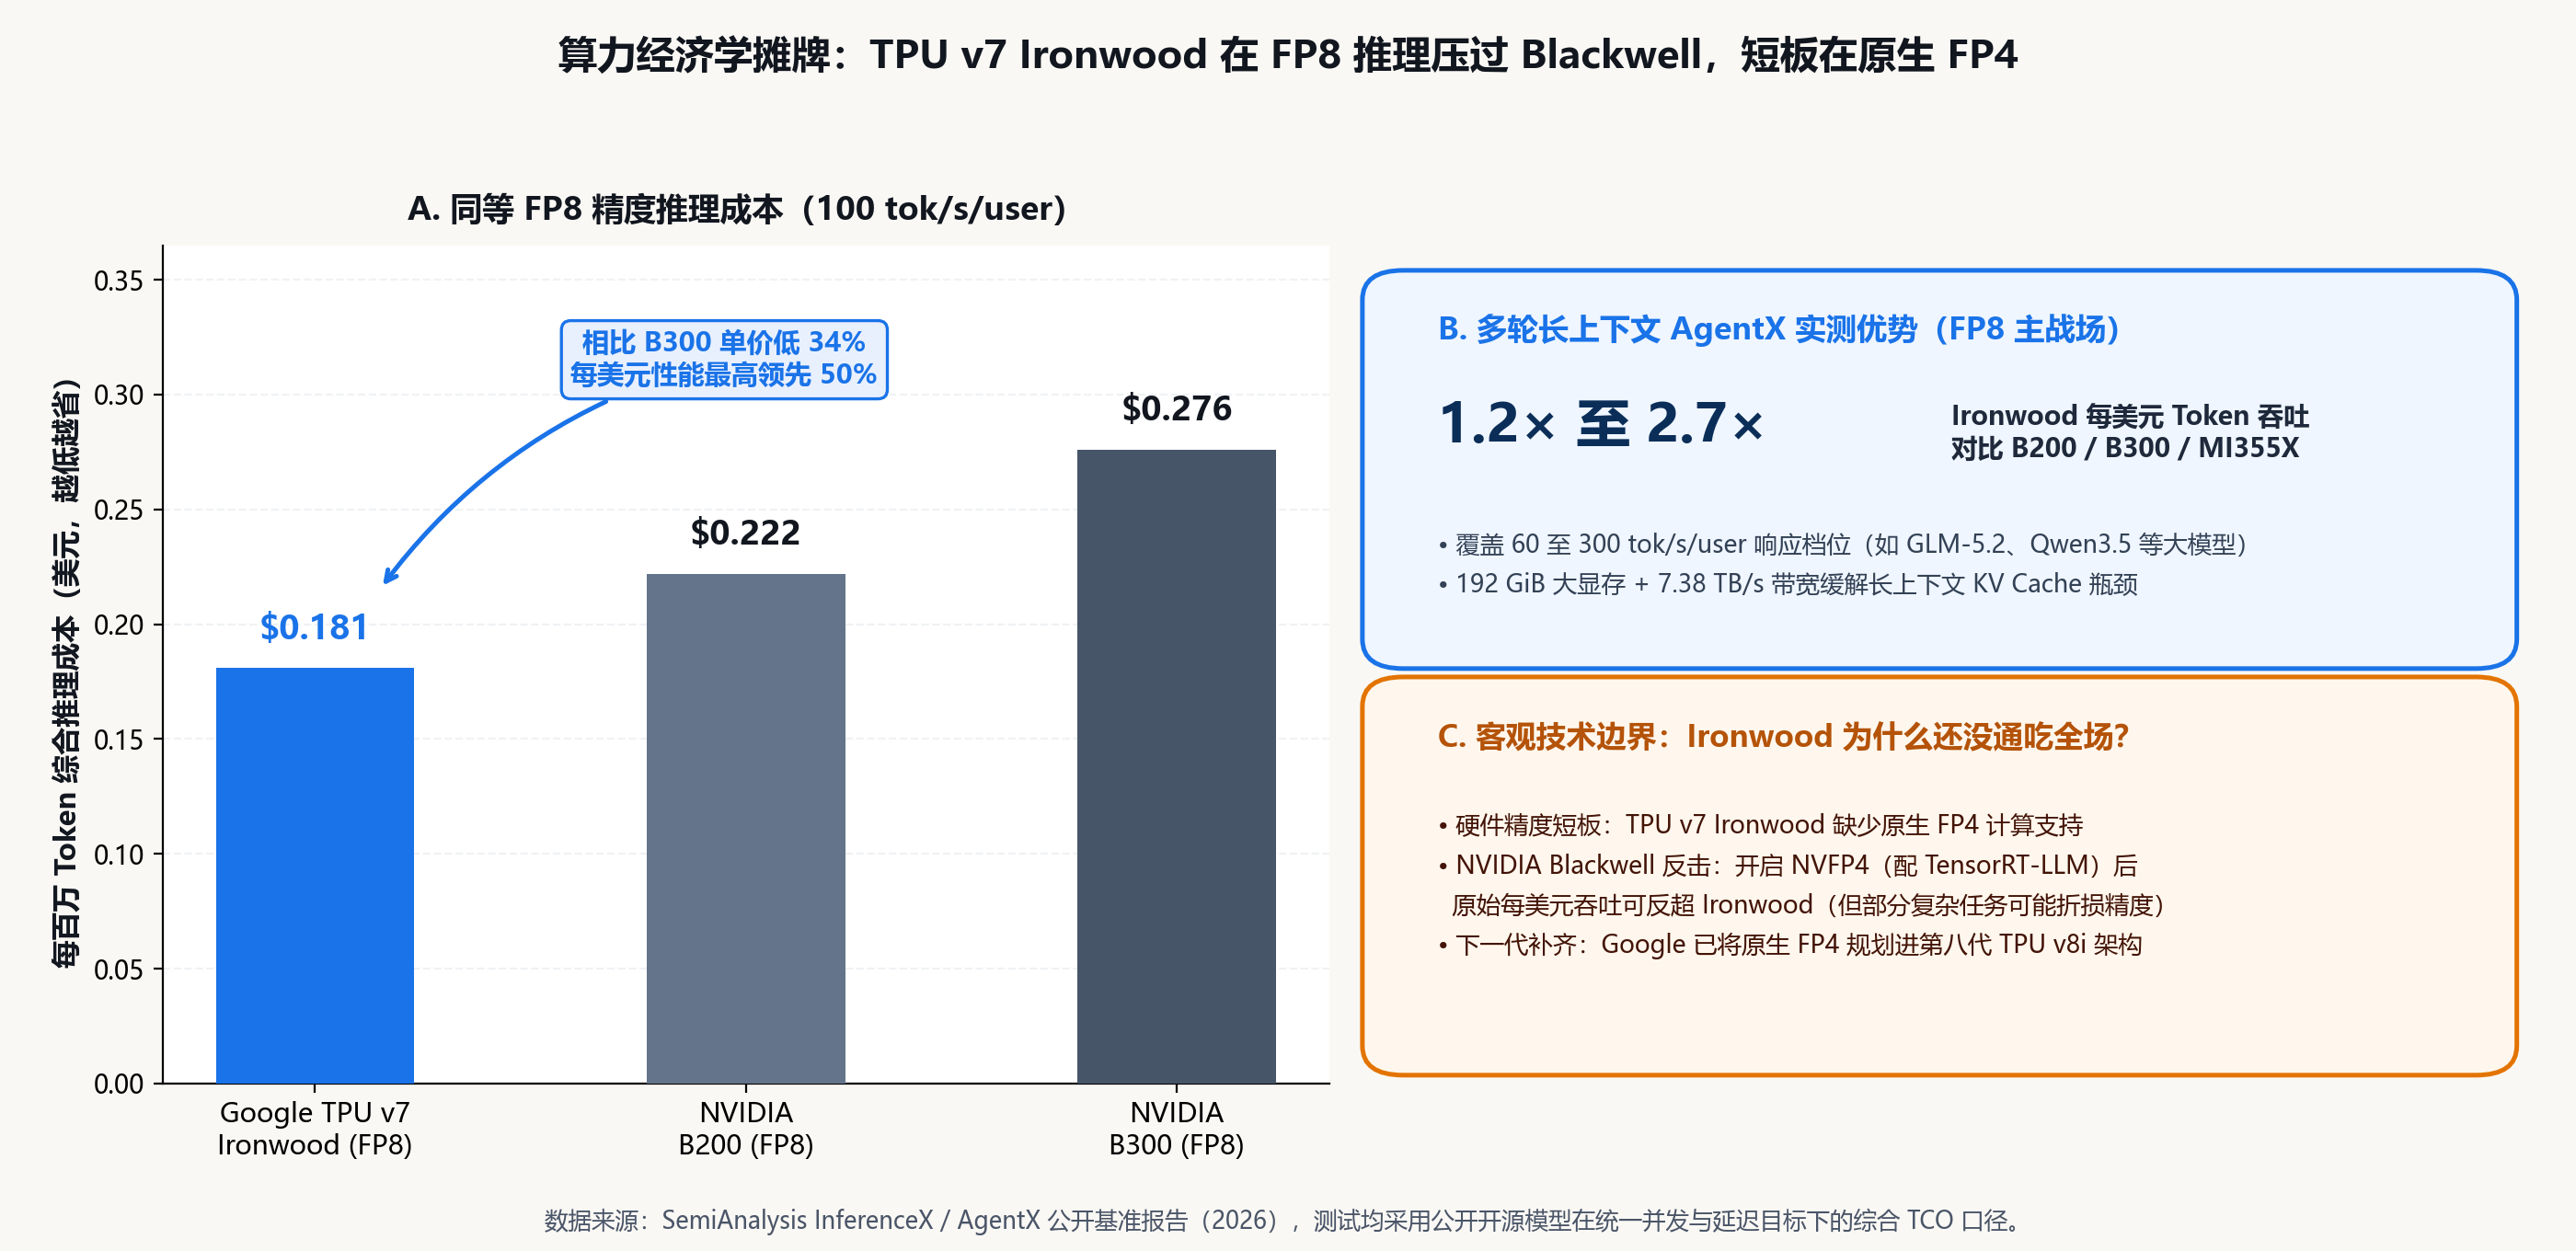
- 同等 FP8 精度下的直接对决:在 Qwen 3.5(397B)等大型开源模型的标准化 FP8 推理测试中,固定交互速度为每秒每用户 100 Token,TPU v7 Ironwood 的综合推理成本低至每百万 Token 约 0.181 美元;相同条件下的 NVIDIA B200 约 0.222 美元,NVIDIA B300 约 0.276 美元。折算下来,Ironwood 的每美元性能(Performance per Dollar)最高领先 B200/B300 约 50%。
- 多轮长上下文智能体(AgentX)差距更大:在模拟真实编程助手与多步工具调用的 AgentX 基准(如 GLM-5.2 等模型、覆盖 60 至 300 tok/s/user 响应区间)上,Ironwood 在 FP8 模式下的每美元 Token 吞吐达到 NVIDIA B200、B300 以及 AMD MI355X 的 1.2 倍至 2.7 倍。
当然,硬核技术拆解不能只报喜不报忧。SemiAnalysis 的实测同样点出了 Ironwood 当前最清晰的一道物理短板:
Ironwood 缺少原生 FP4 硬件计算支持。
当 NVIDIA Blackwell 机柜(如 B200 / B300 / GB300 NVL72)开启独有的 NVFP4 低精度量化推理(搭配 TensorRT-LLM 与 Dynamo 调度)时,英伟达能够靠更低的位宽重新把原始每美元吞吐反超回来,代价则是部分高精度复杂任务上可能伴随轻微的量化精度折损。而 Google 自己也很清楚这块短板,已将原生 FP4 硬件支持排进第八代细分路线图(如面向推理优化的 TPU v8i 架构),用来正面迎战英伟达下一代架构。
但在目前主流前沿模型最看重质量与稳定性的 FP8 实战主战场上,Google 靠自研芯片省下来的那一层高毛利硬件差价,已经实实在在变成了 Gemini 4 Neon 在榜单上那张 7.40 美元对比 17.94 / 24.77 美元的降维打击报价单。
四、拆掉 CUDA 护城河:TorchTPU 与“百万颗 TPU 外销潮”
如果说前六代 TPU 只是 Google 关起门来降本增效的秘密武器,那 2025 至 2026 年发生的最大格局变化,是 Google 开始把整机柜 TPU 直接卖给自己的竞争对手和外部巨头。
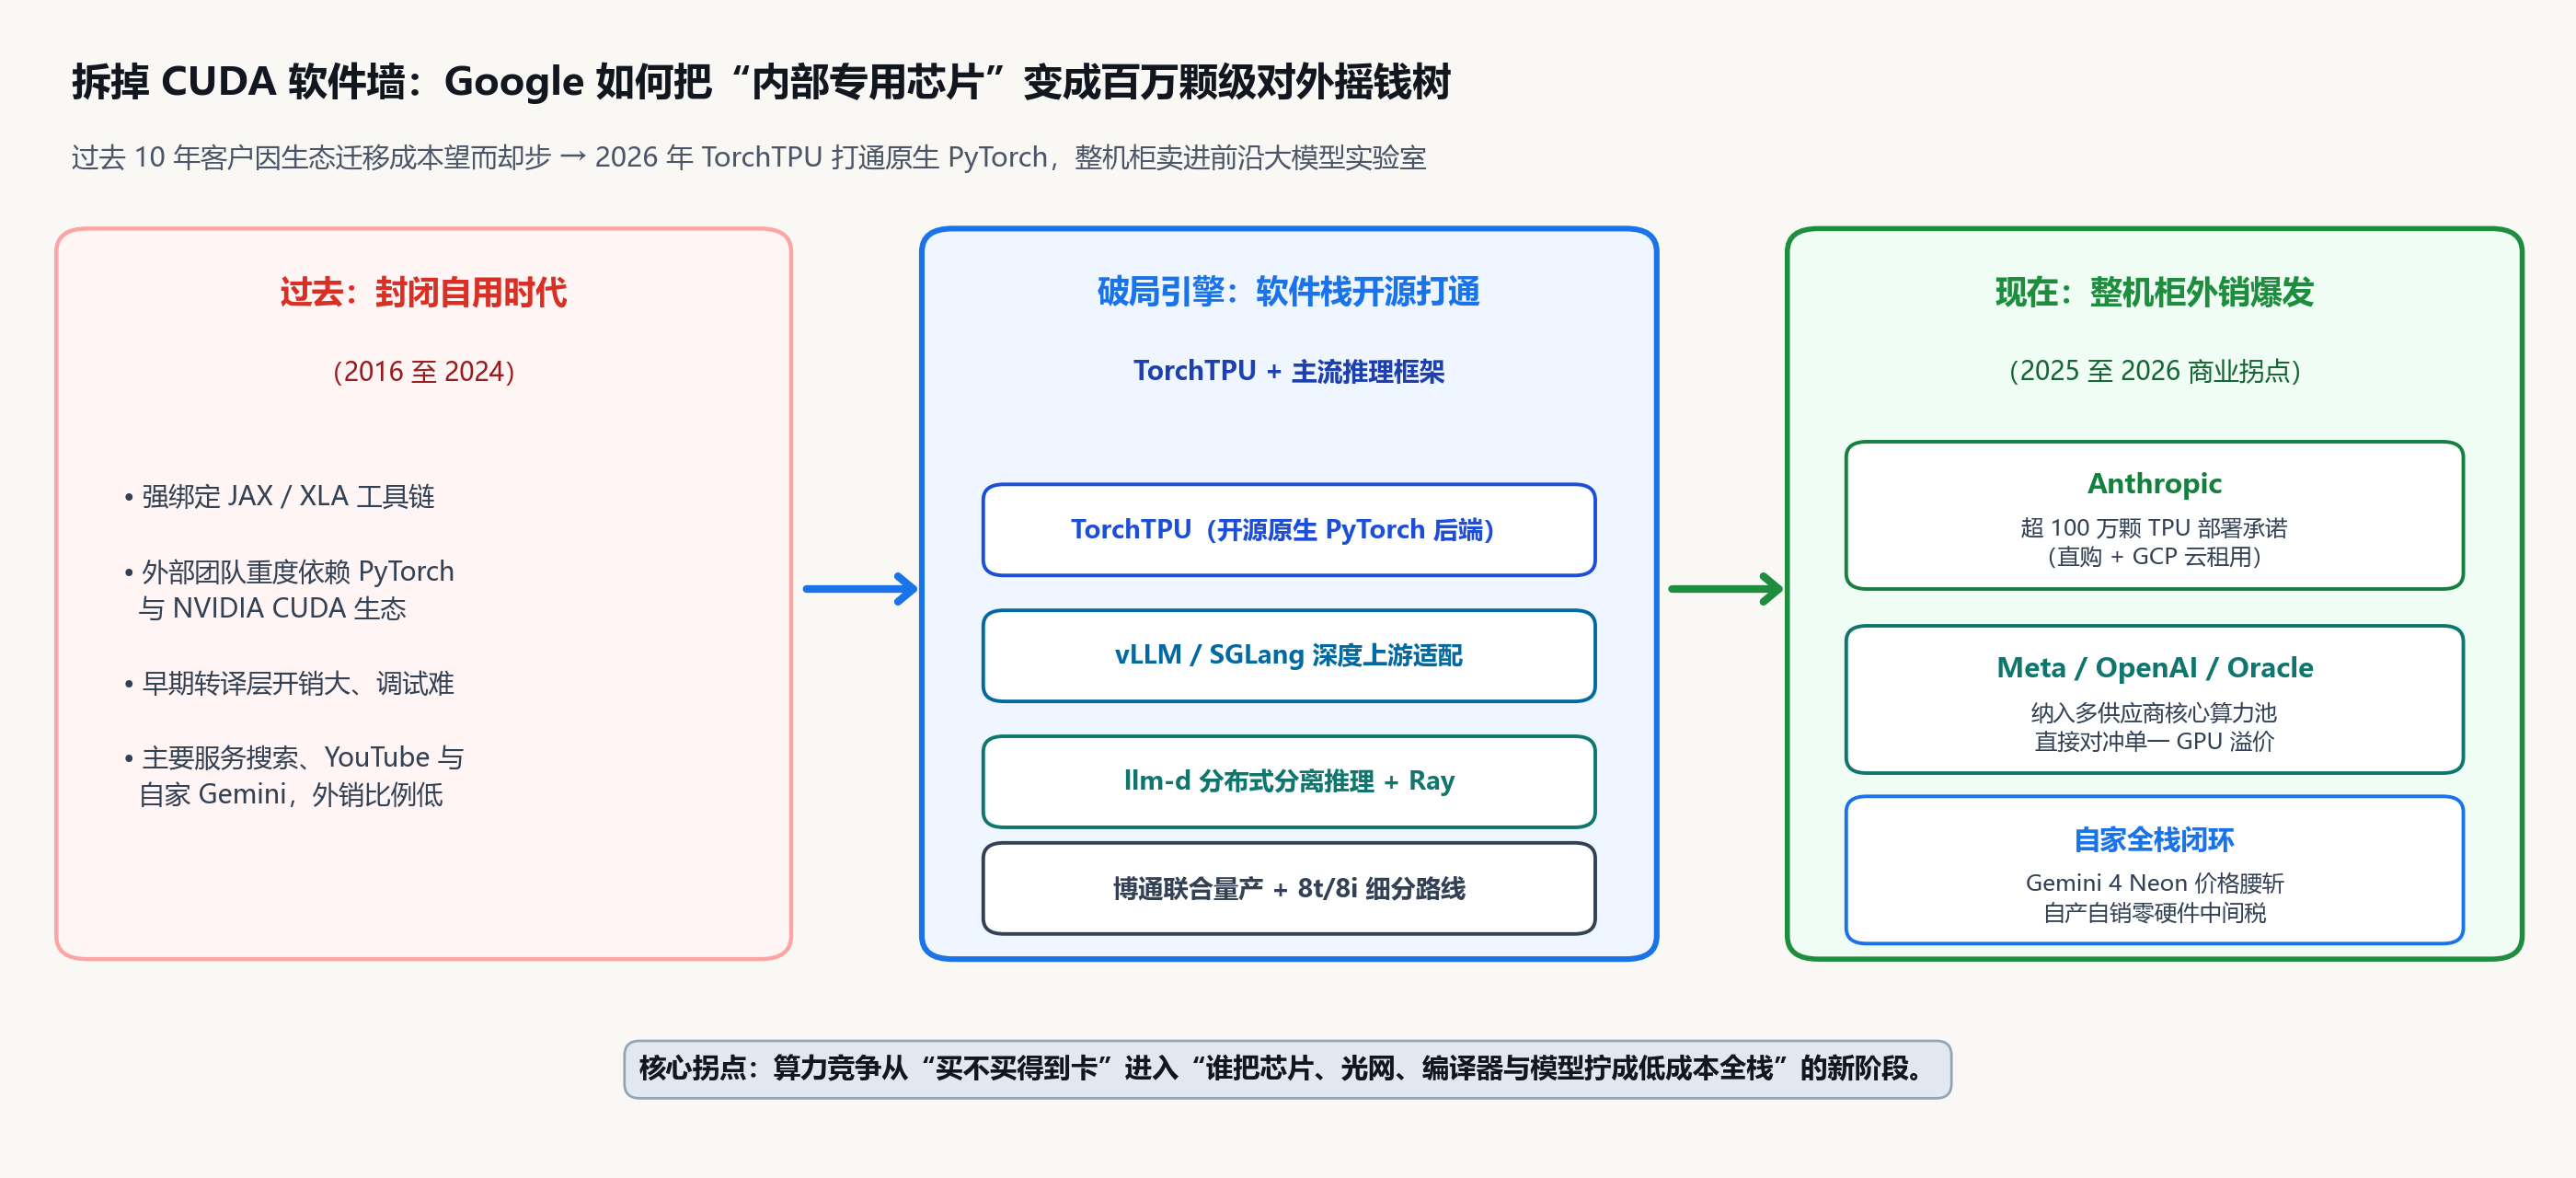
过去十年,外界哪怕知道 TPU 性价比高,也大多不敢轻易迁移,核心阻力只有一个词:CUDA 生态锁定。早期用 TPU 往往意味着重写 JAX 代码或忍受各种转译层的性能损耗,对习惯了 PyTorch 的外部 AI 团队来说迁移成本高到离谱。
这一轮,Google 补齐了最后一块软件短板:推出并开源原生 PyTorch 后端 TorchTPU,直接绕过早期笨重的中间翻译层,同时在上游深度适配 vLLM、SGLang 以及分布式分离推理框架 llm-d 与 Ray。对于外部开发者来说,代码几乎不用大动,就能把原本跑在英伟达显卡上的推理服务直接切上 TPU 集群。
软件墙一旦出现裂缝,算力买家的真金白银就立刻转向。据 SemiAnalysis 产业链跟踪与公开商业披露:
- Anthropic 已签下跨越自购机柜与 Google Cloud 租用的大规模部署承诺,整体 TPU 规划规模突破 100 万颗级别,不仅用于大并发推理,也深度承接前沿基础模型训练;
- Meta、OpenAI、Oracle 等一线科技巨头与云厂商也陆续将 Google TPU 纳入多供应商算力组合,借此对冲单一 GPU 供应商的供货排队与议价压力;
- 面向第八代芯片,Google 进一步将架构明确拆分为偏向训练的 TPU 8t 与偏向推理的 TPU 8i(及长上下文、机密推理等衍生版本),从“内部专用零件”彻底进化为面向全球 AI 基础设施市场的完整产品线。
结语:AI 下半场的胜负手,从参数竞赛变成单位经济战
回头看 Gemini 4 Neon 在 2026 年 11 月掀起的这场震动,它释放的信号其实极其朴素。
过去三年,大模型行业处在上半场,比的是谁先砸钱买到足够多的旗舰显卡、谁先把参数和榜单拉到第一。哪怕每跑一次长链条推理都在亏钱,资本市场也愿意为“前沿能力”买单。
但当一线模型能力纷纷跨过 70% 实用门槛、企业与开发者每天开始调用上百万次多轮 Agent 工作流时,游戏瞬间切换到了下半场:单位经济学(Unit Economics)。同样做到 70.87% 的准确率,谁能把单次任务成本压到 7.40 美元、把响应速度压到 31 分钟,谁就能把原本只用得起中端模型的开发者和企业流量全部吸干。
英伟达凭借 CUDA 生态、NVLink 全机柜互联以及 NVFP4 率先落地的先发优势,依然是全球通用 AI 算力当之无愧的霸主。但 Google 用十年七代 TPU 证明了一件整个科技史反复上演的铁律:当一项核心技术从实验室走向全社会基础设施,真正能打赢长期消耗战的,永远是那些耐得住寂寞、把芯片、光网、编译器与模型全栈攥在自己手里的玩家。
参考与数据口径:Gemini 4 Neon 发布时间、API 定价(输入 3 美元、输出 15 美元、缓存输入 0.15 美元每百万 Token)及 1M 上下文与四档思考等级参数整理自 Google DeepMind 官方发布信息(2026 年 11 月 18 日);Vals Index(准确率 70.87%、成本 7.40 美元、耗时 31 分 25 秒对比 Claude Fable 5.2 / Sonnet 5.5 / Opus 5.5 等)、CursorBench 4.1、Artificial Analysis Intelligence Index v5.0.1、Agent Arena Index 及 Andon Labs Vending-Bench 2 评测结果引自对应第三方公开榜单(2026 年 11 月);TPU v7 Ironwood 规格(双计算裸片、4,614 TFLOPs FP8、192 GiB HBM3E、7,380 GB/s 带宽、1,200 GB/s 双向 ICI、9,216 颗超级 Pod / 42.5 Exaflops / 1.77 PB 共享显存)引自 Google Cloud 技术文档;Ironwood 对比 NVIDIA B200/B300 的 FP8 单位成本(0.181 美元 vs 0.222 / 0.276 美元每百万 Token)、AgentX 1.2 至 2.7 倍每美元吞吐、原生 FP4 边界、TorchTPU 生态进展及 Anthropic 逾百万颗 TPU 部署规模整理自 SemiAnalysis 公开报告与 InferenceX / AgentX 基准披露。
常见问题
Gemini 4 Neon 的性能和定价相比同梯队旗舰模型低多少?
根据 2026 年 11 月 18 日公布的 Vals Index 评测,Gemini 4 Neon 以 70.87% 准确率排名全球第 2(仅落后第 1 名 Claude Fable 5.2 的 71.31% 共 0.44 个百分点),但单次测试成本仅为 7.40 美元,比 Claude Fable 5.2(17.94 美元)便宜约 59%,比 Claude Opus 5.5(24.77 美元)便宜 70%,耗时 31 分 25 秒也是前十中最快,比 Opus 5.5 和 Sonnet 5.5 的约 1 小时 25 分钟快约 2.7 倍。其 API 标准定价为输入 3 美元、输出 15 美元每百万 Token,缓存输入低至 0.15 美元。
Google 第七代 TPU v7 Ironwood 在硬件规格和推理成本上对比 NVIDIA Blackwell 表现如何?
TPU v7 Ironwood 采用双计算裸片与原生 FP8 硬件支持,单芯片峰值算力达 4,614 TFLOPs(FP8),配备 192 GiB HBM3E 显存与 7,380 GB/s(7.38 TB/s)内存带宽,通过三维环面片间互联与光电路交换机(OCS)可扩展至 9,216 颗芯片、42.5 Exaflops FP8 总算力与 1.77 PB 共享显存。据 SemiAnalysis InferenceX 实测,同等 FP8 精度与 100 tok/s/user 交互速度下,Ironwood 单百万 Token 推理成本约 0.181 美元,对比 NVIDIA B200(0.222 美元)和 B300(0.276 美元)每美元性能最高领先 50%;多轮长上下文 AgentX 场景每美元吞吐达 B200/B300 的 1.2 至 2.7 倍。
Google TPU 目前最大的技术短板和生态进展分别是什么?
软件生态层面,Google 通过推出原生 PyTorch 后端 TorchTPU 并深度接入 vLLM、SGLang 等主流推理框架,大幅降低了从 CUDA 迁移的改造成本,已开始将整机柜 TPU 对外销售与出租给 Anthropic(承诺规模超过 100 万颗)、Meta、OpenAI 与 Oracle 等外部客户。但硬件精度层面,TPU v7 Ironwood 缺少原生 FP4 支持,在依赖 NVFP4 的极限低精度高并发场景下 NVIDIA Blackwell 仍具优势,原生 FP4 能力留待 Google 下一代 TPU v8i 架构补齐。
写春秋管理咨询 · 顾问直连(自 2005)
扫码领《同行业人效数据表 / 咨询签约核查单》
微信扫码添加写春秋顾问企业微信,发送「核查单」即可领取本文配套工具表。如企业已有明确改善计划,请直接留言「所在城市 + 行业 + 人数 + 当前卡点」,资深顾问本人对接。
自测工具: 97 家企业人效对标计算器 · 计件改计效与调薪保本测算 · 人效分位与咨询选型对照表
首席顾问:刘新珍(国防科大工程师出身 · 中国首位女性 ICMC 认证咨询师 · 20余年管理咨询经验) · 地址:深圳市光明区招商局光明科技园 B2-1402