行业观察
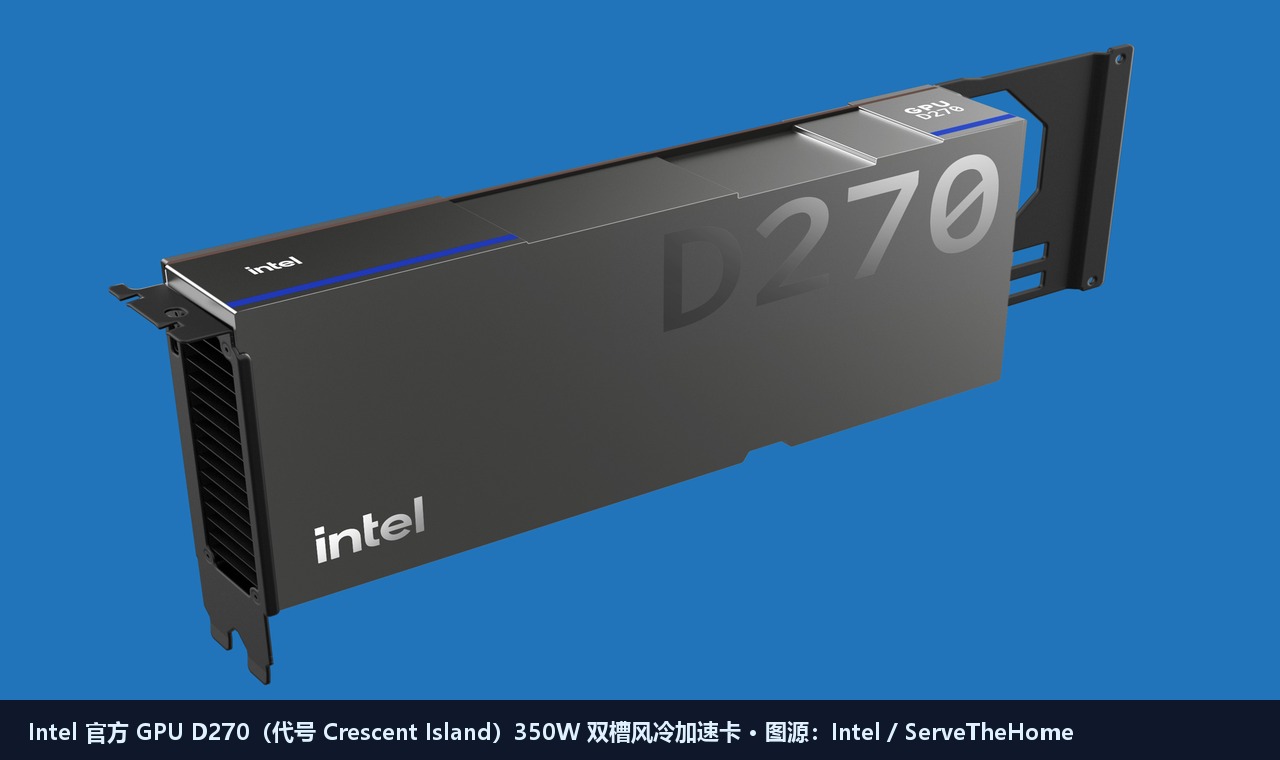
最近在芝加哥召开的 SC26 超级计算大会上,英特尔甩出一份极具火药味的测试成绩单。它拿着一块还没正式发售的 350W 风冷加速卡 Intel GPU D270(研发代号 Crescent Island,新月岛),直接叫板英伟达 600W 功耗的旗舰服务器卡 NVIDIA RTX PRO 6000 Blackwell 服务器版,宣称在金融衍生品定价负载里吞吐量最高达到对手的 5.9 倍。
消息一出,国内外硬件圈立刻分成两派。一派看着“功耗少四成、性能快近六倍、显存最高 480G”的标题热血沸腾,另一派则本能怀疑英特尔是不是又在玩 PPT 跑分套路。在急着站队之前,我们干了两件别人没干的事:第一,顺藤摸瓜翻完英特尔架构师在 Hot Chips 2026 公开的原始硅片幻灯片、ServeTheHome 与 Phoronix 等一线硬核硬件媒体的现场拆解,以及开发者社区的真实争议;第二,直接拿了一张英特尔对标的同款真卡 NVIDIA RTX PRO 6000 Blackwell 服务器版(96GB GDDR7,600W),现场跑了一遍精度断崖、金融定价、制造业 CAE 方程求解和显存撞墙实测。
实测跑完,5.9 倍背后那层窗户纸瞬间就捅破了,而英特尔真正想打的另一张底牌也彻底浮出水面。
一、大 V 和一线硬件圈都在聊什么?先把热闹里的干货捞出来
在进入实测数据前,先看清海内外真正懂服务器和芯片架构的大佬们怎么评价这块怪卡。因为 D270 目前仍处于工程样片送测阶段,消费级评测频道还没摸到零售卡,真正贡献一手干货的是三拨人:
第一拨是 ServeTheHome(Patrick Kennedy 与 Ryan Smith 团队)。他们在 Hot Chips 2026 和 OCP 全球峰会现场拍全了英特尔 19 页架构幻灯片,也是最早把 D270 完整规格钉死的媒体:32 个 Xe3P 核心、256 个 XMX 矩阵引擎、约 2.5 GHz 主频、1.3 PFLOPS 稠密 FP8 算力、10.2 TFLOPS 原生 FP64 算力,以及 20 颗 LPDDR5X 组成的 1,280-bit 位宽与 1.5 TB/s 带宽。Patrick Kennedy 在现场看完演进路线后给出了一个极其毒辣的判断:D270 的带宽和定位根本不是拿来单挑 HBM 液冷训练怪兽的,英特尔在现场把它和 SambaNova 绑在一起做解耦推理,说明它本质上是一块“风冷大显存预填充加速卡”,但他紧接着补了一句实话,说自己太想弄一块 480GB 风冷版插进工作站里试试了。
第二拨是 TechPowerUp、TechSpot 与 Phoronix 等硬核技术媒体。TechSpot 直接把报道焦点锁死在“无图形渲染(graphics-free)”四个字上,点出英特尔把传统显卡里负责画图和光线追踪的硅片面积全砍了;TechPowerUp 和行业分析师则一头扎进 SC26 的跑分小字里,揪出金融测试用的是“单路 Xeon 6741P 装单卡 D270”去对照“八卡 RTX PRO 6000 服务器节点”,而常规 AI 推理对照基线则跑在 AWS 云虚机上;Phoronix 主编 Michael Larabel 则一直紧盯 Linux 内核 Xe 驱动和 OpenCL / Level Zero 运行时,确认英特尔在硬件上市前已经把开源底层驱动铺进了主线。
第三拨是 Reddit r/LocalLLaMA 和 Hacker News 上的本地大模型极客。这群每天为显存焦虑的开发者压根不在乎华尔街期权定价快几倍,他们盯着“ODM 合作版最高 480GB LPDDR5X 风冷单卡”疯狂算账:一张卡吃下 3,000 亿参数模型、八卡装进 1 万亿参数,还不用砸钱改液冷机柜。不过冷静的声音同样尖锐,最高赞的几条讨论全部指向同一个担忧:报价没出,上市要等到 2027 年,而 SYCL 加 oneAPI 到底能不能在真实生产环境里扛住 CUDA,还得等真卡出货才算数。
二、真卡实测同款 600W 旗舰:一秒看穿 5.9 倍的田忌赛马
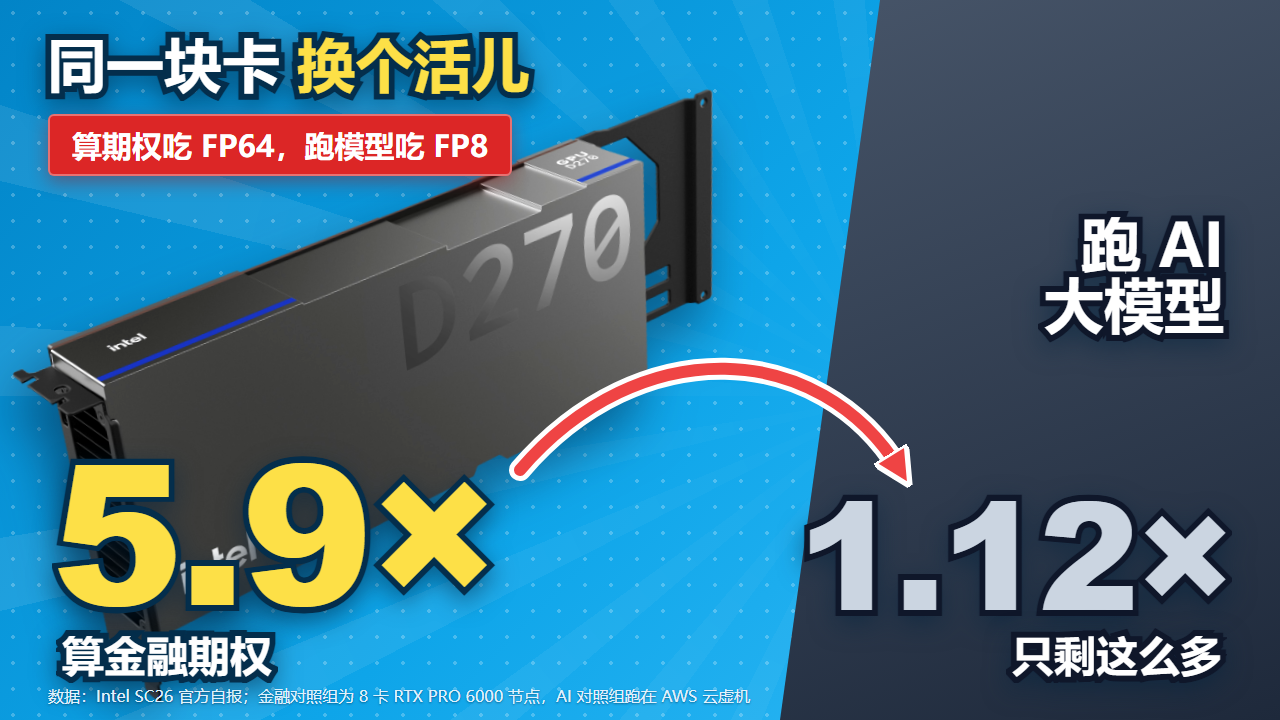
只看英特尔自己放出的 6 组 SC26 数据,反差就已经摆在桌面上了:在欧式蒙特卡洛(5.90 倍)、欧式 Black-Scholes(5.60 倍)、二叉树定价(4.60 倍)和美式期权模型(1.92 倍)这四项吃满 FP64 双精度浮点的金融负载里,D270 赢面极大;可一旦切回企业最关心的常规大模型推理,跑 Qwen3-30B-A3B(FP8)的输出 Token 吞吐量立刻回落到 1.12 倍,在 Drex v2.0 决策模型上延迟下降 29%。
为什么同一对硬件,换个负载差距能从 5.9 倍瞬间缩水到 12%?为了不靠嘴说,我们直接拿来英特尔选作靶子的同款真卡 NVIDIA RTX PRO 6000 Blackwell 服务器版(188 组 SM、97,887 MiB 显存、600W TDP、PCIe Gen5 x16、Driver 580.82.07、PyTorch 2.14.1+cu130),亲自跑了一整套实测,全程通过 nvidia-smi 实时抓取核心频率、温度与功耗。
第一组矩阵算力实测一出来,老黄精准的“产品分级刀法”就彻底摊牌了。在这块 600W 旗舰卡上:
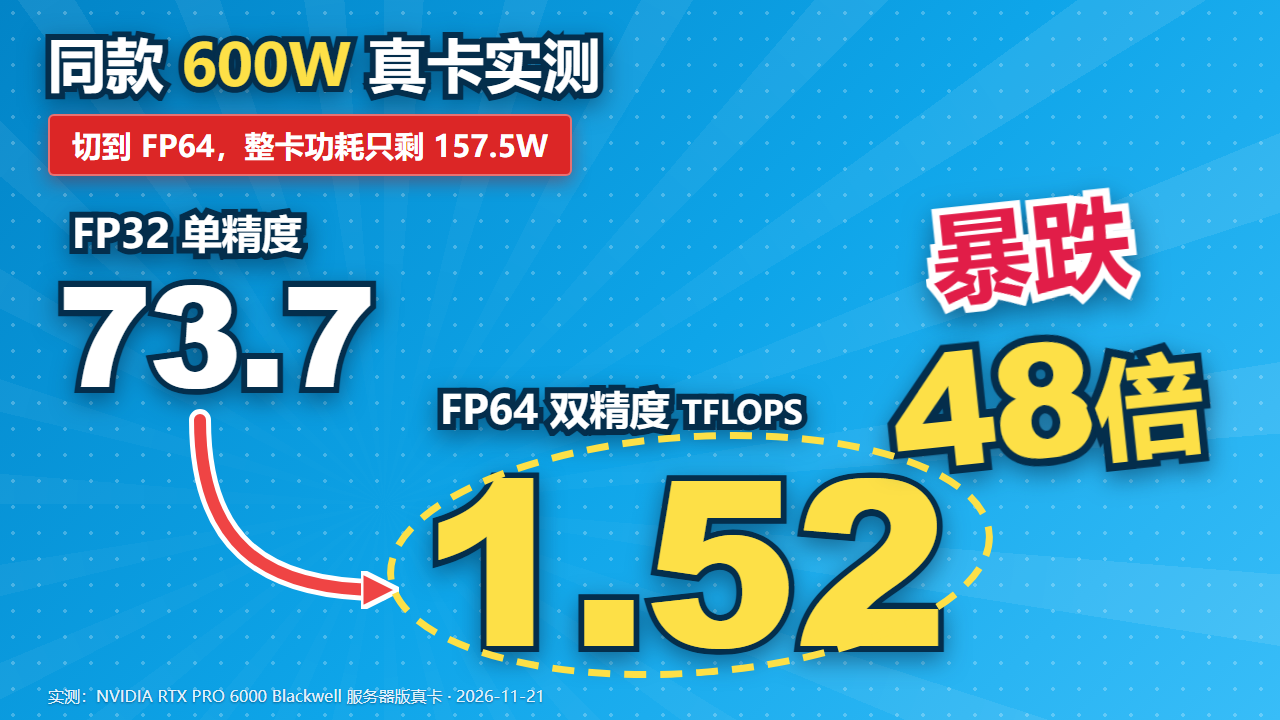
跑 FP8 Tensor(N=16384),实测算力高达 792.12 TFLOPS(平均功耗 273.4W,峰值 380.0W,核心频率 2,244 MHz);跑 BF16 Tensor(N=16384),实测 409.17 TFLOPS(平均功耗 519.1W,峰值 556.4W);跑 FP16 Tensor 达 397.27 TFLOPS(平均 583.7W);跑 TF32 Tensor(N=12288) 录得 202.54 TFLOPS,平均功耗直接顶到 596.8W(峰值 602.1W);哪怕退到严格 IEEE FP32 单精度(N=12288),依然能稳定输出 73.68 TFLOPS,平均功耗 577.1W(峰值 613.1W),整张卡火力全开。
可一旦把数据类型切到严格 IEEE FP64 双精度(N=8192),魔幻的一幕发生了:实测算力从 73.68 TFLOPS 垂直坠落到 1.52 TFLOPS,比严格 FP32 暴跌 48.47 倍,比 BF16 慢了 269.19 倍,比 FP8 慢了 521.13 倍!更扎心的是功耗和频率监控数据:跑 FP64 时,芯片频率反而飙到全程最高的 2,325 MHz,整卡功耗却骤降到 157.5W(峰值仅 157.8W,温度跌到 42.2 摄氏度)。一块标称 600W 的数据中心巨兽,连四分之一功耗都吃不满,核心全在干等。
原因一点也不神秘。RTX PRO 6000 Blackwell 共享消费级 Blackwell 芯片(GB202)血统,英伟达为了保护售价数万美元的液冷 H200、B200 数据中心训练卡,把工作站与专业图形线硅片上的 FP64 双精度执行单元硬砍到了单精度的几十分之一。现在拿笔算一笔小学除法就全明白了:我们实测 RTX PRO 6000 服务器版的真实 FP64 吞吐是 1.52 TFLOPS,而英特尔给 D270 塞进去的原生满血 FP64 标称 10.2 TFLOPS,两者纸面就差了 6.7 倍!英特尔故意避开满血双精度的 B200 和 H200,挑着 FP64 金融期权去撞 RTX PRO 6000,跑出 5.6 倍到 5.9 倍根本不是魔法,而是精准踩中了架构分级墙。
为了看清这种限速在真实业务里有多痛,我们紧接着在同一块 RTX PRO 6000 上跑了金融定价和制造业工程仿真两组实测:
在 欧式 Black-Scholes 期权定价(1,000 万份期权循环 25 轮) 中,FP32 单精度耗时 14.26 ms(每秒 175.36 亿份),切到 FP64 立刻拉长到 75.06 ms(每秒 33.31 亿份),单卡慢了 5.26 倍,平均功耗只有 197.0W;在 欧式蒙特卡洛(800 万条路径走 64 步) 中,FP32 只要 4.85 ms(每秒 16.48 亿路径),切到 FP64 跌至 23.21 ms(每秒 3.45 亿路径),慢了 4.78 倍。
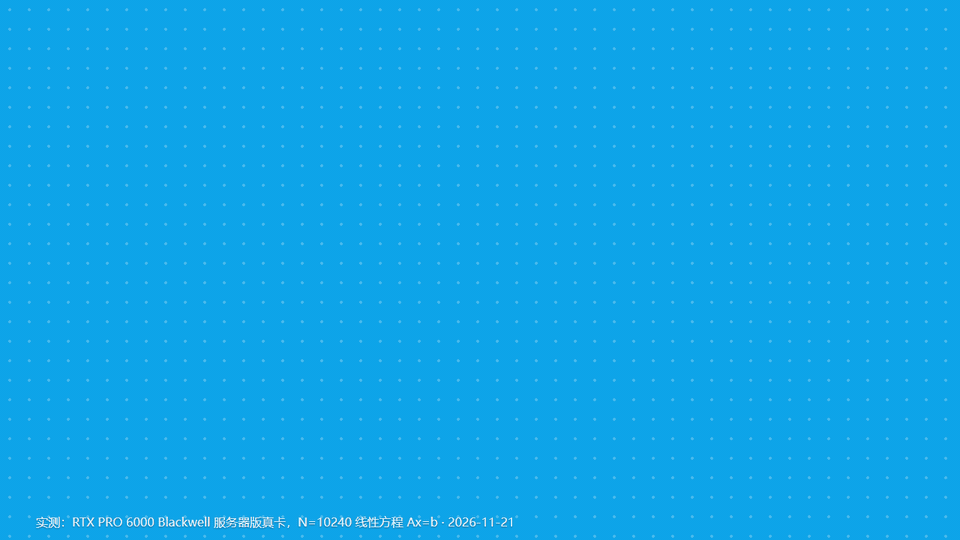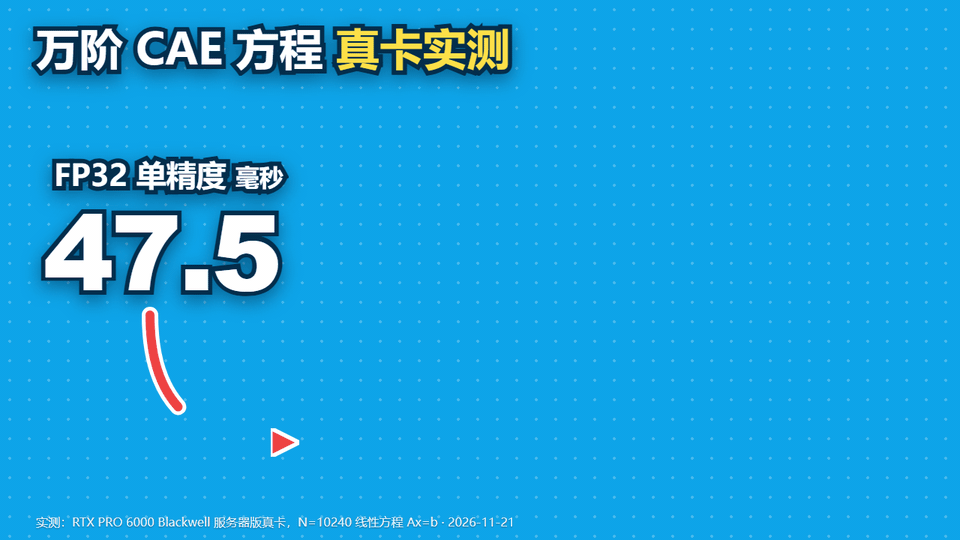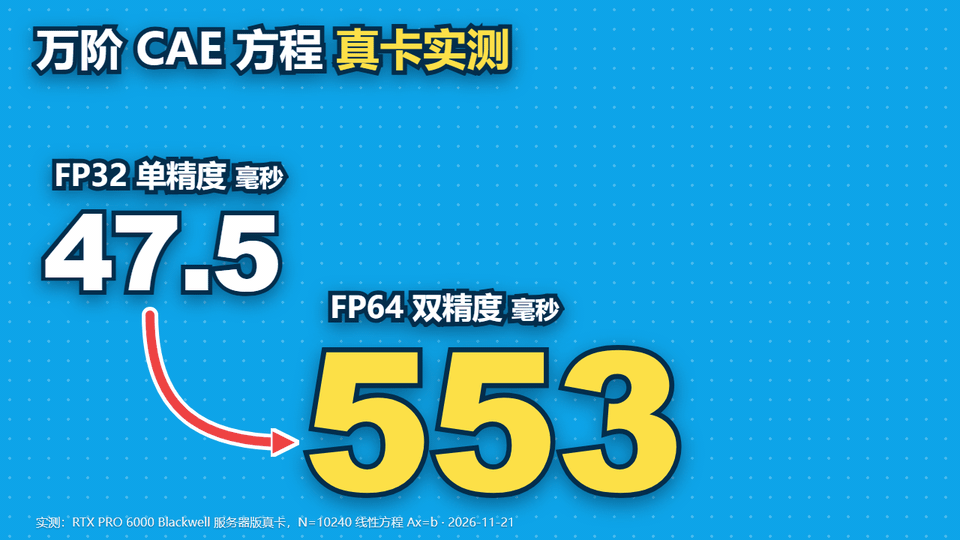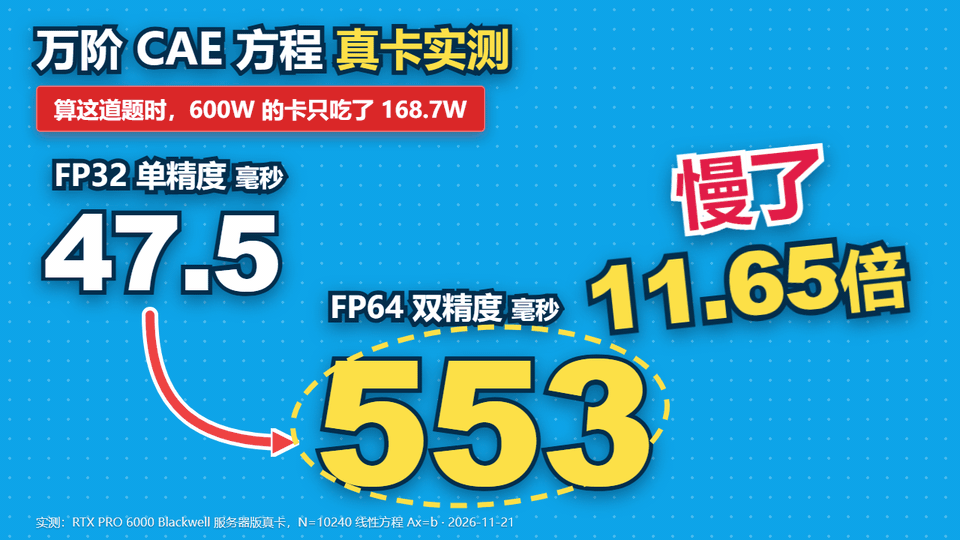
到了制造业最熟悉的 CAE 有限元线性方程组求解(Ax = b),这种痛感更加直接。矩阵规模 N=6144 时,FP32 只要 22.37 ms,但最大求解残差停在 7.39×10⁻⁶,切到 FP64 后残差压低 8 个数量级到 5.64×10⁻¹⁴,耗时却跳到 143.66 ms(慢 6.42 倍);把矩阵放大到 N=10240(万阶刚度矩阵),FP32 耗时 47.47 ms(残差 7.63×10⁻⁶),FP64 残差稳在 7.86×10⁻¹⁴,耗时却暴涨到 553.08 ms,直接慢了 11.65 倍,而此时 600W 旗舰卡的实际功耗只有 168.7W!对搞汽车碰撞、结构有限元、流体力学与热仿真的制造企业来说,用单精度误差一累积迭代就发散,逼着必须跑双精度,老黄的工作站卡却在这里锁死了 90% 的算力。
三、扒完 5.9 倍水分,D270 真正吓人的底牌是“砍掉渲染 + 480G 显存”
如果只把 D270 当成一次鸡贼的跑分营销,就看轻英特尔这步棋了。打开英特尔首席企业 AI 系统架构师 Sumit Mohan 与 Intel Fellow Hong Jiang 在 Hot Chips 2026 公开的硅片平面图与架构演进页,你会发现 D270 压根不是一张传统显卡,而是一块从零按 AI 推理账本重画出来的“怪卡”。
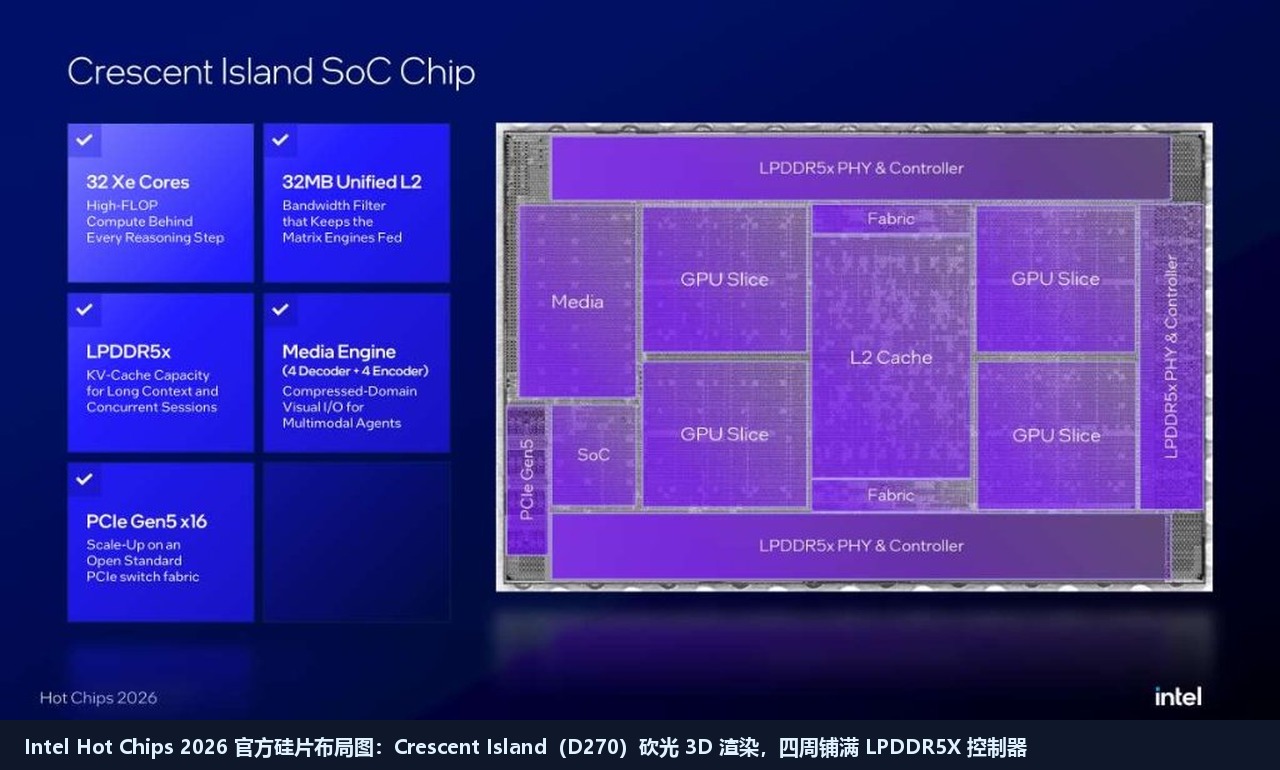
第一刀,它把显卡祖传的 3D 光栅渲染、光线追踪和显示输出管线全部砍光,只保留了面向多模态智能体的媒体编解码引擎(4 路解码加 4 路编码)。省出来的晶体管面积全部砸进计算与缓存:对比消费级 Xe2(Battlemage,20 个 Xe 核、4 级深度 XMX 脉动阵、每核仅 8 FMA FP64、18MB L2、24GB GDDR6),D270 采用的 Xe3P 直接扩到 32 个 Xe 核,把 256 个第三代 XMX 矩阵引擎拉深到 16 级脉动阵(4 倍深度),原生支持从 FP4 / MXFP4、FP8 到满血 FP64(每核 64 FMA,是 Xe2 的 8 倍),连 Sigmoid 和 Tanh 激活函数都做了硬件加速,每核通用寄存器翻倍到 1MB、L1/SLM 翻倍到 512KB,片上统一 L2 缓存拉大到 32MB。
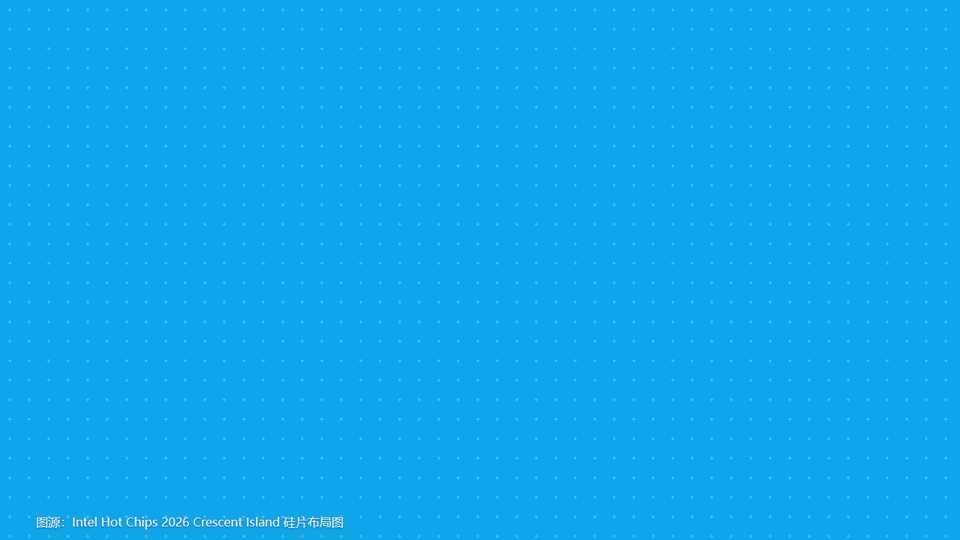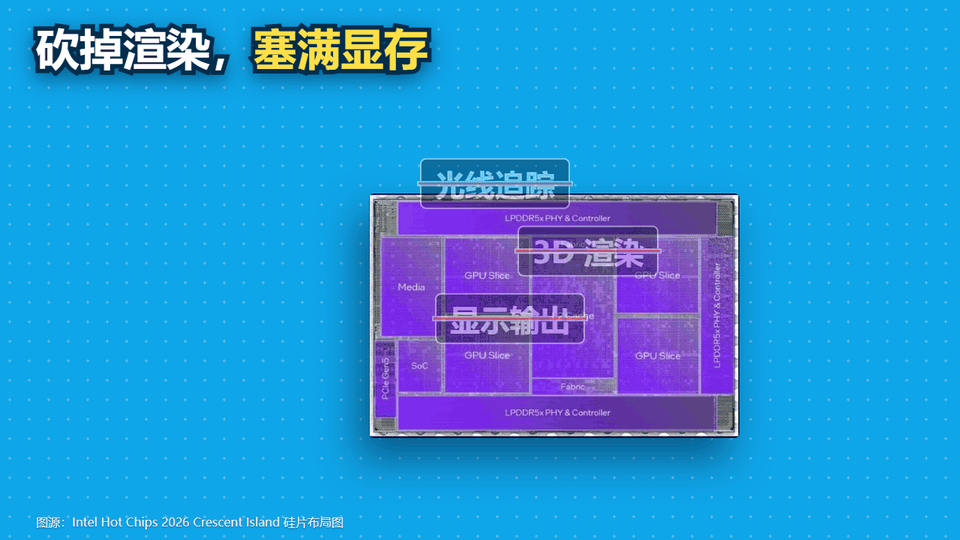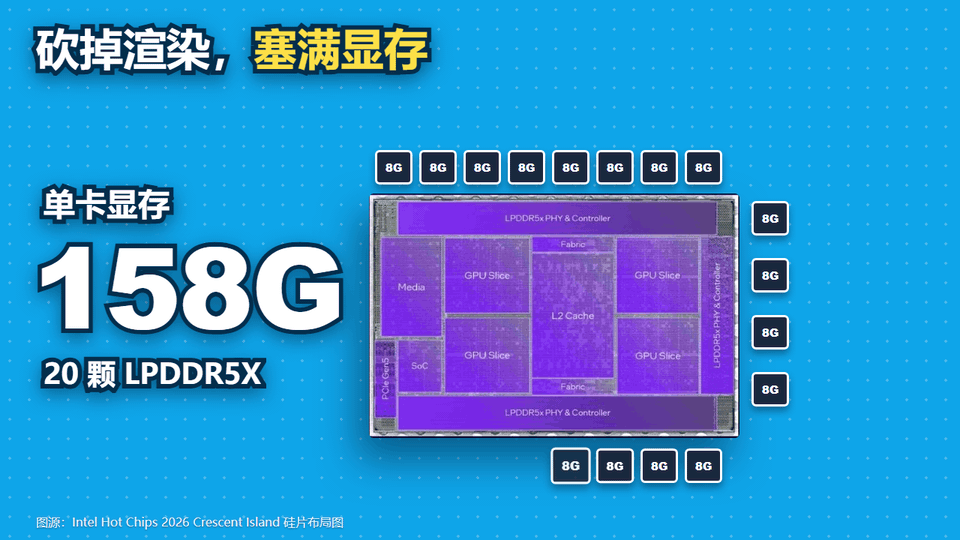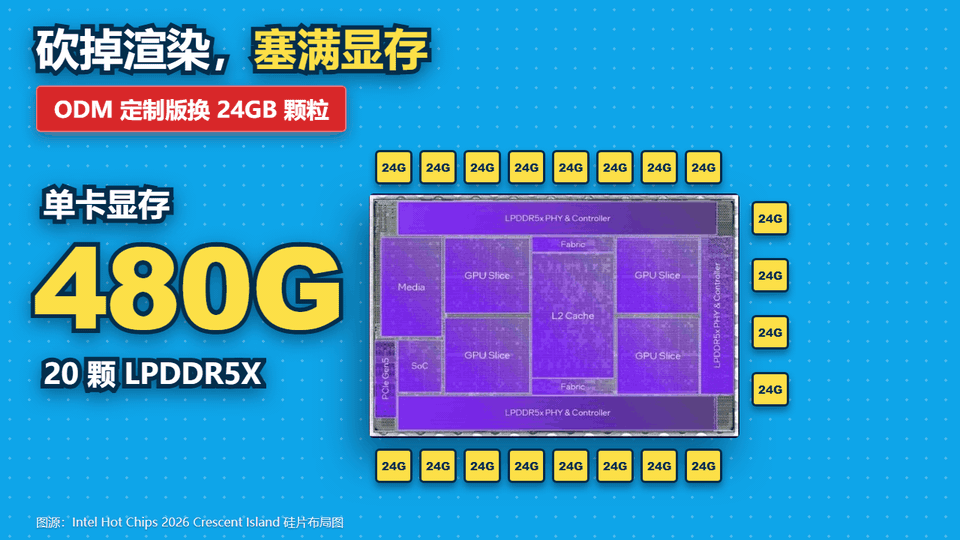
第二刀更狠,直戳当前 AI 算力最贵的那块肉:扔掉高不可攀的 HBM,用 20 颗 LPDDR5X 硬堆海量显存。
过去三年,行业默认数据中心 AI 卡必须上天价 HBM,否则带宽不够看。但英特尔架构师在 Hot Chips 2026 第 15 页幻灯片上甩出一组让所有人都沉默的实测规律:从 2024 年的稠密模型 Llama 2 70B 演进到 2025 至 2026 年的稀疏混合专家模型(MoE),包括 DeepSeek-V3/R1、Qwen3-235B-A22B、Kimi K2 1T、DeepSeek-V4-Pro 乃至 Kimi K3 2.8T,模型所有权重常驻显存所需的总容量暴涨了 7.5 倍,可每生成一个 Token 实际需要从显存读取的字节数反而下降了 4.4 倍!几乎所有主流稀疏 MoE 模型,单 Token 激活读取量都安静地躺在 3 到 78 GB 的底层区间里。
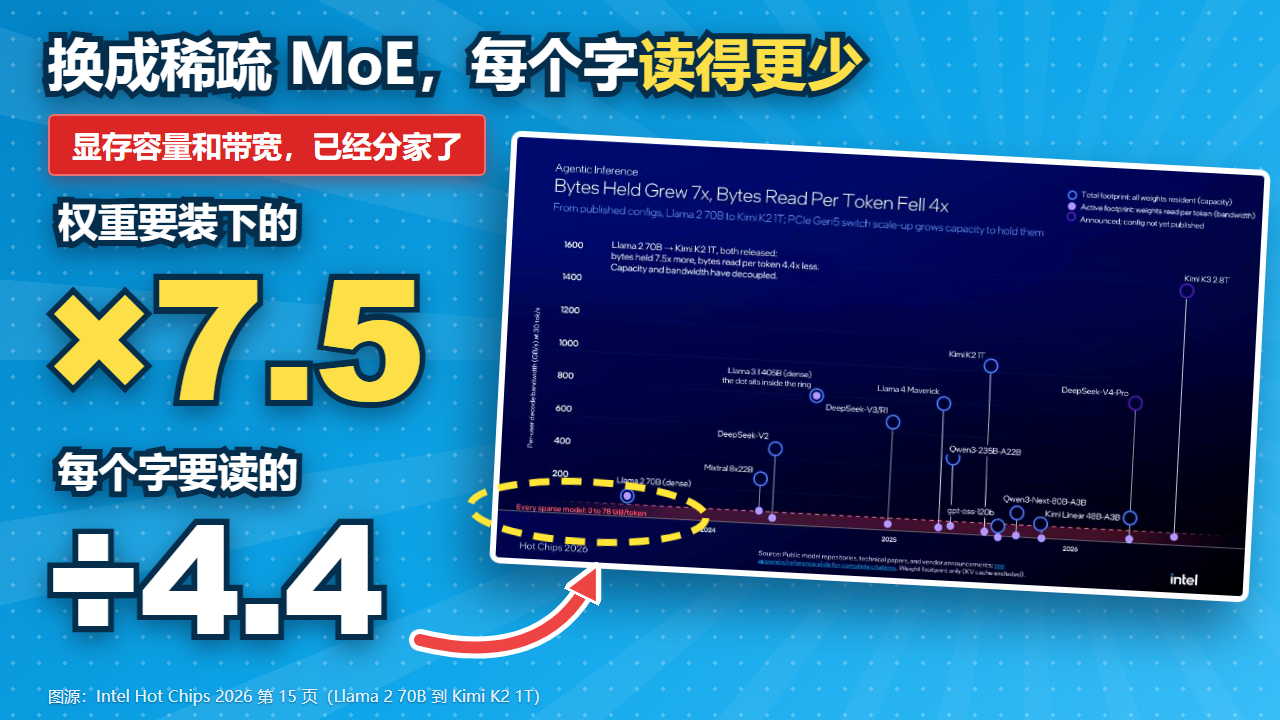
用大白话说,大模型推理的“显存容量”和“显存带宽”已经彻底解耦了。企业私有化部署一个几千亿参数的 MoE 知识库或长上下文编程 Agent,真正把卡逼死的不是带宽,而是“装不下权重和 KV Cache”。
我们拿这张 RTX PRO 6000 服务器版顺手测了一把显存墙和实测带宽:它的 GDDR7 实测 4GB 拷贝带宽是 1.46 TB/s(理论标称约 1.60 TB/s),总可用显存 94.97 GB,按 8GB 步进连续分配,分到 88 GB 之后在 96 GB 处直接触发 CUDA OutOfMemoryError 撞墙报错。这意味着只要你想在本地用 FP8 跑一个 235B 参数的 Qwen3-235B-A22B,或者给百亿级模型挂上几十路并发的长上下文 KV 缓存,单张零售约 1.6 万美元、整机渠道 2.1 万到 2.5 万美元的 RTX PRO 6000 立刻捉襟见肘,必须买两三张做多卡并行,功耗瞬间冲上 1,200W 到 1,800W。
反观英特尔 D270 的解法:绕开产能紧缺的 HBM,在芯片三侧焊满 20 颗 LPDDR5X 颗粒,组成 80 通道、1,280-bit 超宽位宽,以约 9,375 MT/s 跑出 1.5 TB/s 带宽并带完整 ECC 校验与动态坏页隔离。也就是说,它的实测带宽跟 600W 的 RTX PRO 6000 几乎平起平坐,功耗压在 350W 标准双槽风冷(常规企业风冷机柜直接插,不用花大钱改造液冷,空载低至 10W 到 50W),而显存容量在英特尔原厂卡上就有 160GB(20×8GB),ODM 合作定制版换上 24GB 颗粒直接冲到 480GB(20×24GB)。单卡装下 3,000 亿参数模型、八卡常规风冷机柜塞进万亿参数,这就是为什么连 ServeTheHome 主编都眼馋那块 480G 风冷卡。
四、SC26 现场暗藏的真正打法:不搞单挑,搞异构解耦与科学仿真
光堆容量不看场景,容易把 LPDDR5X 吹成万能神药。英特尔自己心里最清楚 1.5 TB/s 带宽的边界在哪里,所以它在 SC26 芝加哥展台上直接亮出了两套真实落地样板。
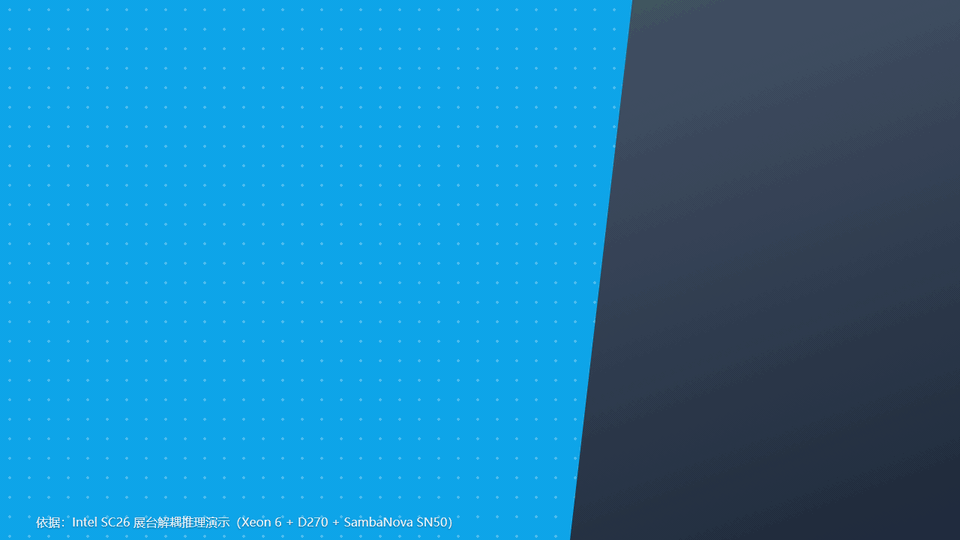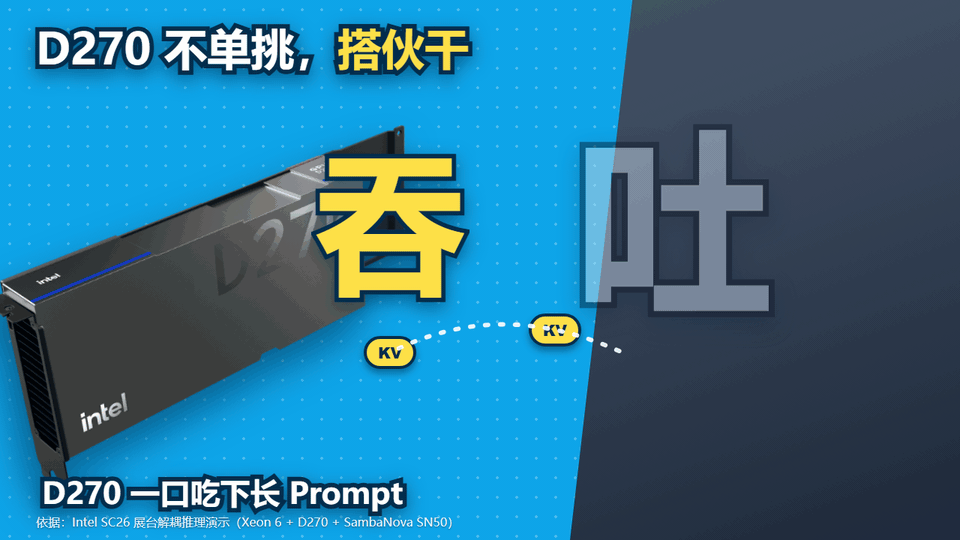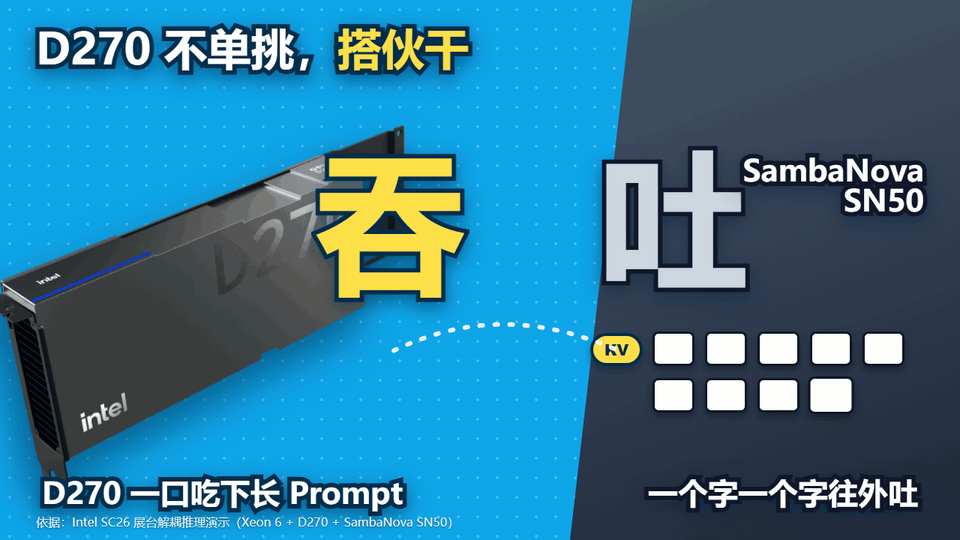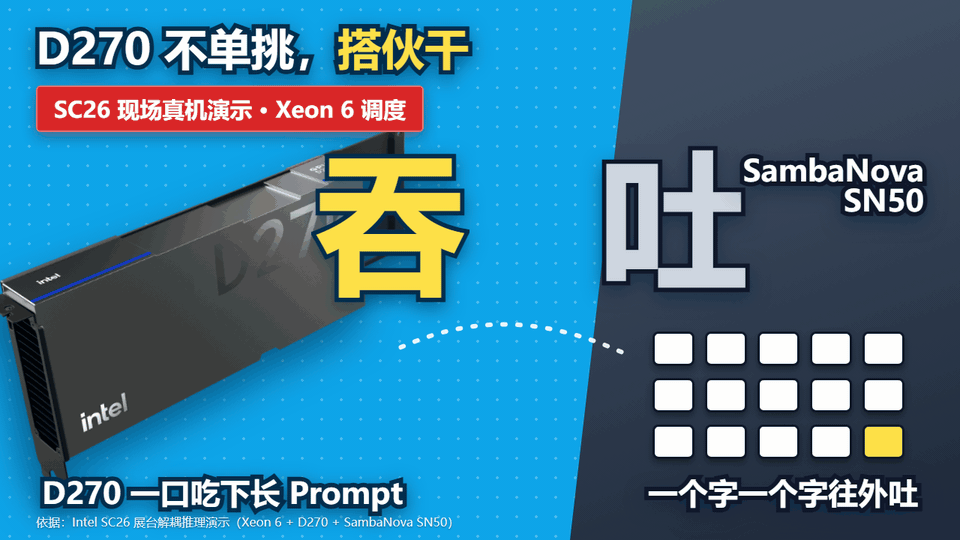
第一套是 与 SambaNova 联手的风冷异构解耦推理。在长上下文智能体任务里,推理天然分成性格截然相反的两半:前半段“预填充(Prefill)”要一口气吃进几万甚至几十万字 Prompt 并建立 KV Cache,极度吃矩阵算力和显存容量;后半段“解码吐字(Decode)”是一个字一个字往外蹦,极度吃显存带宽。英特尔展台的真机方案是由 Xeon 6 做控制调度,让 350W 风冷 D270 凭 160G 到 480G 大显存和 256 个 XMX 矩阵引擎专吃重算力的 Prefill,再通过 PCIe Gen5 和 vLLM、SGLang、NIXL 与 NVIDIA Dynamo 开放接口,把算好的 KV 状态交给 SambaNova SN50 RDU 芯片做极速吐字 Decode。
第二套则是 与 Viridien 合作的 3D 地震波物理仿真演示。地震勘探、油气建模和我们前面实测的制造业 CAE 结构与流体仿真本质上是一回事:三维网格体量动辄上百 GB,既要求整块三维波场常驻显存避免通过 PCIe 来回倒腾,又对 FP32 和 FP64 精度极其挑剔。过去工业仿真部门只有两个扎心的选项:要么咬牙买几万美元一块的液冷 HBM 数据中心卡,要么买专业工作站卡却被 1.52 TFLOPS 的残血 FP64 拖成慢动作。如果 D270 真能把 10.2 TFLOPS 原生 FP64 和 160G 到 480G 风冷显存打进合理价位,它撬动的将不只是 AI 推理,而是整个制造与科研院所的中端 CAE 仿真底座。
五、先别急着喊英特尔翻身:三张卡摊开,3 个绕不开的硬伤
把夸赞收一收,站在真金白银花预算的企业和制造研发负责人角度,我们把 Intel GPU D270、NVIDIA RTX PRO 6000 Blackwell 和同为 PCIe 服务器形态的 AMD Instinct MI350P(600W、2.3 PFLOPS 稠密 FP8、3.6 到 4.0 TB/s HBM 级别带宽)并排摆上桌面,D270 至少有三个非常现实的硬伤,现在谁拍胸脯喊“买它替代英伟达”都是不负责任。
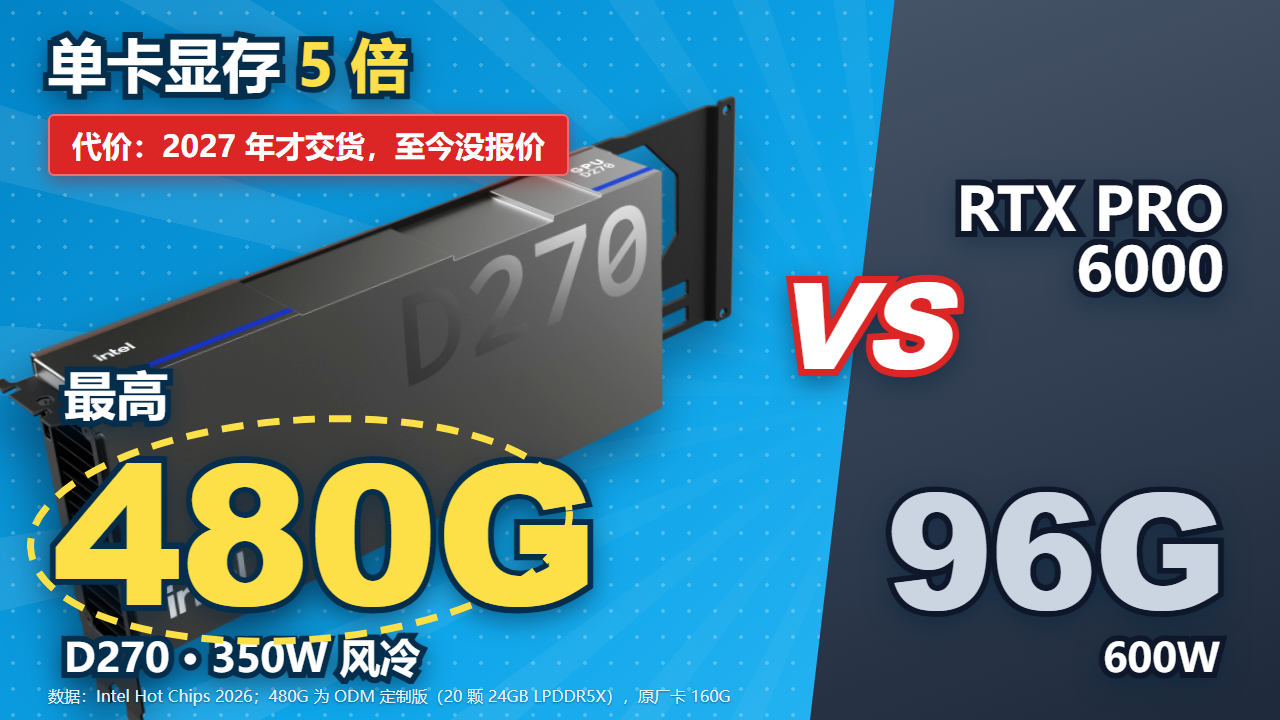
第一个硬伤是 交付时间与历史信用账。D270 是英特尔自 2021 年 Ponte Vecchio 之后第一款真正端上台的商用数据中心 AI GPU,中间连续砍掉了 Rialto Bridge(2023 年取消)和 Falcon Shores(2025 年取消)两代产品。目前 D270 仍停留在向客户送测工程样片的阶段,大规模上市要等到 2027 年,而且最要命的 官方报价和 480GB ODM 版的真实溢价至今一字未提。别忘了,如今高容量 LPDDR5X 颗粒本身也并不便宜,等到 2027 年 D270 真正批量铺货时,英伟达下一代 Rubin 架构与 AMD 新一代产品也已就位,窗口期非常窄。
第二个硬伤是 CUDA 生态绑定与软件迁移人天。英特尔这次学聪明了,从立项就强调 Day-0 支持 PyTorch、Triton、vLLM、SGLang,底层走 SYCL、oneDNN、oneCCL 和 Level Zero 开源栈。跑通几个热门开源大模型推理问题不大,但只要走进制造企业和金融机构的真实机房,大量跑了十年的 ANSYS、Abaqus 插件、自研 CFD 求解器和私有量化库全是深度绑定 CUDA 的老代码。哪怕硬件采购省了 30%,一旦团队需要花半年人天去重写算子、查精度对齐和修驱动兼容,省下来的卡钱分分钟全赔进研发工资里。
第三个硬伤是 1.5 TB/s 的物理带宽上限。LPDDR5X 换来了惊人的 480GB 容量和 350W 低功耗,但代价是它的内存带宽只有 AMD MI350P 或 HBM 旗舰卡的三分之一到五分之一,峰值 FP8 算力(1.3 PFLOPS)也比 600W 的 MI350P(2.3 PFLOPS)低了约四成。如果企业跑的是全参数激活的稠密大模型,或者要求单卡扛极高并发的极速首字与吐字延迟,D270 根本不是对手,必须老老实实把它放进稀疏 MoE、长上下文预填充或双精度仿真这三条精准赛道里。
六、算力采购不是看跑分,是算清四张组织账
写春秋管理咨询在给中大型制造企业做研发数字化和组织力诊断时,反复碰到一个特别典型的浪费:技术团队拿一张外媒的“5.9 倍领先”截图去立项,老板听着省电又便宜就批了预算,结果机器拉回机房才发现,要么是软件生态接不上老业务系统,要么是机房配电和风道扛不住 600W 满载,最后昂贵的算力卡在角落里吃灰。
回看这次英特尔 D270 叫板英伟达 RTX PRO 6000 的整场大戏,真正值得企业技术负责人和老板抄进采购清单的,不是“谁打赢了谁”,而是四张硬账表:
- 精度账:先问清团队 80% 的核心负载到底吃 FP8 / BF16,还是像有限元仿真、流体力学、量化定价一样死磕 FP64。如果是后者,千万别顺手买消费级血统的工作站卡,我们拿 RTX PRO 6000 亲手跑出来的 1.52 TFLOPS(慢 11.65 倍) 就是最贵的学费。
- 显存与模型结构账:未来两年企业私有化部署的主力大概率是稀疏 MoE 架构加超长上下文 Agent。显存容量不够会直接卡死能不能跑起来,单卡 96GB 在 2026 年已经频繁触顶,选型时必须把“单卡或单机可承载显存总量”排在峰值纸面算力前面。
- 机房与电费账:很多传统制造企业的数据中心根本没有液冷条件,普通风冷机柜塞进 600W 卡群后,散热、噪音和配电改造成本常常比显卡本身还高。350W 风冷大显存这条路线哪怕英特尔动作慢了半拍,也已经把市场最真实的刚需指明了方向。
- 组织与迁移成本账:写春秋管理咨询一直提醒研发决策层,硬件便宜从来不是总拥有成本(TCO)低的同义词。在没有拿到 2027 年真卡样机、没有用自家真实业务代码在目标软件栈上跑通 72 小时压测之前,对任何“尚未报价的期货跑分”保持冷静观察,拿它作为明年采购谈判的筹码,远比贸然押注更稳妥。
信息整理与实测说明:本文涉及 Intel GPU D270(Crescent Island)硬件架构、规格与 SC26 基准数据,整理自 Intel Hot Chips 2026 官方架构幻灯片、Intel SC26 官方发布资料及 ServeTheHome、TechPowerUp、TechSpot、Phoronix 公开报道;文中所列 NVIDIA RTX PRO 6000 Blackwell 服务器版精度算力、实时功耗、带宽、金融定价、CAE 线性方程求解与 96GB 显存上限数据,均由测试团队于 2026 年 11 月 21 日使用 NVIDIA RTX PRO 6000 Blackwell Server Edition 真卡(97,887 MiB 显存,Driver 580.82.07,PyTorch 2.14.1+cu130)实际运行测得。本文为客观技术分析,不构成任何硬件采购或投资建议。
常见问题
英特尔 350W 的 GPU D270 为什么能在 SC26 跑出比 600W 英伟达 RTX PRO 6000 快 5.9 倍的成绩?
核心原因在于 FP64 双精度算力的产品分级差距。我们直接拿英特尔对标的同款 NVIDIA RTX PRO 6000 Blackwell 服务器版真卡(188 组 SM、96GB GDDR7、600W)实跑验证,FP8 矩阵算力高达 792.12 TFLOPS、严格 FP32 达 73.68 TFLOPS,但切到严格 FP64 瞬间暴跌 48.47 倍至 1.52 TFLOPS,整卡功耗也跌到 157.5W 空转。而 Intel GPU D270 配备原生满血 FP64(每核 64 FMA、标称 10.2 TFLOPS),两者双精度纸面就相差 6.7 倍,因此欧式蒙特卡洛(5.9×)与欧式 Black-Scholes(5.6×)大幅领先;但切回常规 FP8 AI 推理(Qwen3-30B-A3B),D270 吞吐领先迅速收窄至 1.12 倍。
Intel GPU D270 为什么放弃 HBM,改用 20 颗 LPDDR5X 堆出 160GB 到 480GB 显存?
英特尔架构师在 Hot Chips 2026 第 15 页幻灯片中指出,从稠密模型 Llama 2 70B 演进到 DeepSeek-V3/R1、Qwen3-235B-A22B、Kimi K2 1T 等稀疏 MoE 模型后,常驻显存的总容量需求暴涨 7.5 倍,而每生成一个 Token 实际读取的字节数反而下降 4.4 倍(大多落在 3 到 78 GB 之间),容量需求与带宽需求已经解耦。D270 通过 20 颗 LPDDR5X 组成 80 通道 1,280-bit 总线,在 350W 标准风冷下给出 1.5 TB/s 带宽(与我们实测 RTX PRO 6000 的 1.46 TB/s 拷贝带宽几乎打平),原厂卡提供 160GB,ODM 定制版可达 480GB,避开了高价 HBM 的供给与液冷门槛。
制造业 CAE 有限元仿真为什么会受到 RTX PRO 6000 双精度限速的直接影响?
结构力学有限元、流体力学与精密热仿真对数值收敛极为敏感。我们在同一块 RTX PRO 6000 Blackwell 服务器版上实测 N=10240 万阶线性方程求解(Ax=b):使用 FP32 单精度耗时 47.47 ms,但最大残差停在 7.63×10⁻⁶;切回 FP64 双精度后残差压低 8 个数量级至 7.86×10⁻¹⁴,耗时却暴涨至 553.08 ms(直接慢了 11.65 倍),而此时 600W 旗舰卡实际功耗仅 168.7W。这说明工作站级专业卡在双精度工程仿真中存在明显的硬件限速墙。
制造企业和研发团队现在能直接把 Intel GPU D270 列入明年采购方案吗?有哪些现实硬伤?
建议保持观察,先别急着下单。第一,英特尔前两代数据中心 GPU(Rialto Bridge 与 Falcon Shores)均已取消,D270 目前仍在工程样片送测期,大规模量产要等到 2027 年,且官方与 480GB ODM 版的真实价格尚未公布;第二,虽然承诺 Day-0 支持 PyTorch、Triton、vLLM 和 SGLang,但制造业大量老牌 CAE 插件与私有算法深度绑定 CUDA,转向 SYCL 与 oneAPI 的研发迁移人天可能超过硬件差价;第三,1.5 TB/s 带宽上限决定了稠密大模型和高并发吐字不是其主场,需配合稀疏 MoE 或解耦推理架构使用。
写春秋管理咨询 · 顾问直连(自 2005)
扫码领《同行业人效数据表 / 咨询签约核查单》
微信扫码添加写春秋顾问企业微信,发送「核查单」即可领取本文配套工具表。如企业已有明确改善计划,请直接留言「所在城市 + 行业 + 人数 + 当前卡点」,资深顾问本人对接。
自测工具: 97 家企业人效对标计算器 · 计件改计效与调薪保本测算 · 人效分位与咨询选型对照表
首席顾问:刘新珍(国防科大工程师出身 · 中国首位女性 ICMC 认证咨询师 · 20余年管理咨询经验) · 地址:深圳市光明区招商局光明科技园 B2-1402