行业观察
两周前,Tarform 电气工程师 Simon Bullock 测试过一次“让通用大模型直接画 PCB 电路板”,结果非常现实:模型几乎没有物理空间直觉,把 ESP32 模组直接扔在板子正中央,把降压变换器上下颠倒着摆,接口连接器也飘在远离板边的地方。紧接着 Anthropic 和 Diode Computers 接连放出端到端硬件设计演示,大厂明显准备往硬件工程方向压进。
Simon Bullock 没有去跟大模型硬拼参数规模,而是反过来做了一套截然相反的试验:从 GitHub 与社区公开的开源电路板里精挑出 245 块 干净的 KiCad 设计,在 Modal A100-80GB 上用两阶段微调(QLoRA SFT 加在线强化学习 Online GRPO)训练了一个开源 32B 模型 Qwen2.5-Coder-32B-Instruct,再去盲测 23 块 从未参与训练的新主板(21 块留出开源验证板加 AI_Hydro_Controller、HydroPCB 两块自定义水培控制器)。
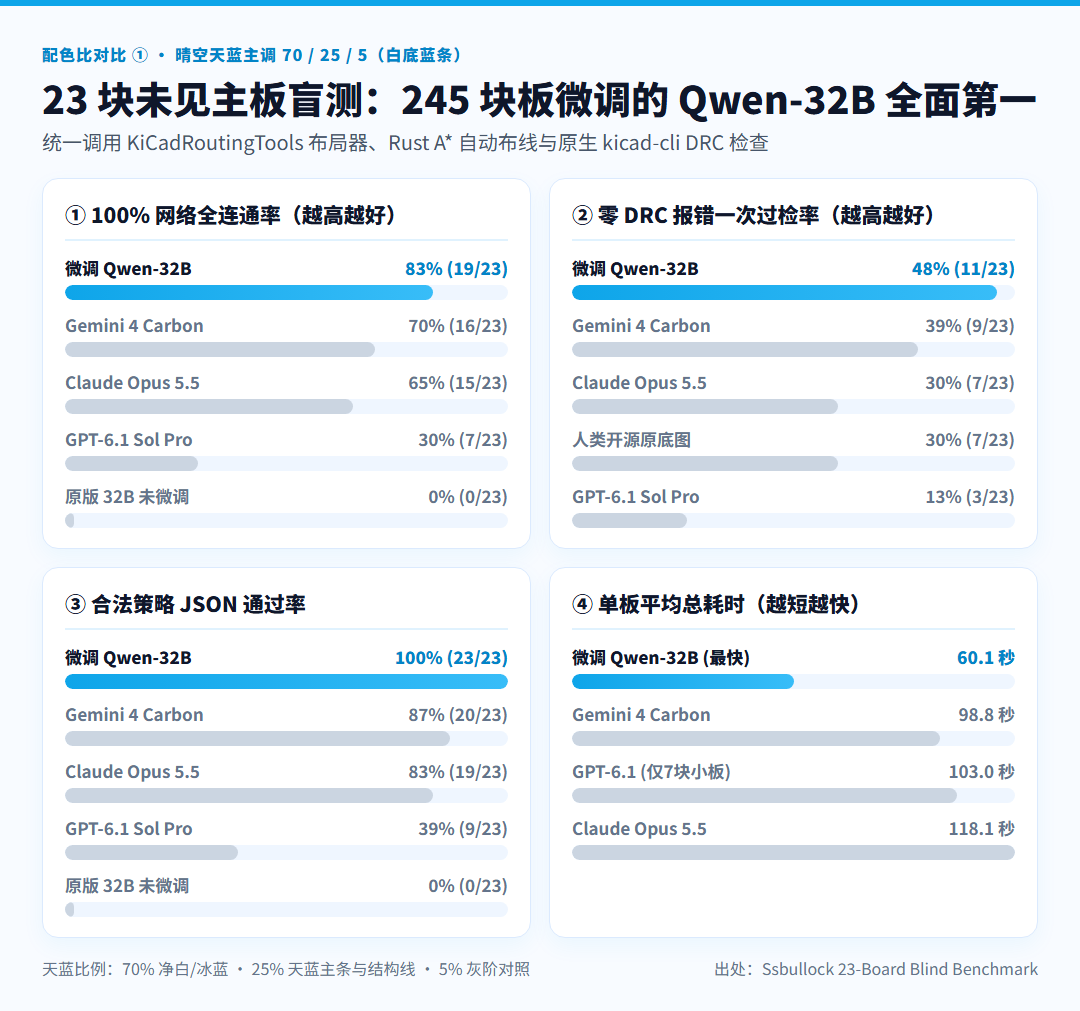
跑完同一套布线与设计规则检查后,结果把所有零样本闭源大模型全甩在了身后:微调后的 32B 模型做到 23/23(100%) 合法结构输出、19/23(83%) 全部网络零阻塞连通、11/23(48%) 零 DRC 报错一次过检,反超 Gemini 4 Carbon(70% 连通 / 39% 零 DRC)、Claude Opus 5.5(65% / 30%)与 GPT-6.1 Sol Pro(30% / 13%),单板平均推演耗时只有 60.1 秒。
83 秒实测讲解视频: 结合 GitHub 开源实机运行画面与 23 块盲测结果,完整拆解这套仅靠 245 块板微调 32B 模型的双层布线架构与三条真实边界。
一、不让AI猜坐标,才是开源32B反超大模型的关键
通用大模型之所以画不好电路板,根源在于硬让文本模型去吐出成百上千个元器件的绝对 X/Y 坐标,哪怕偏掉零点几毫米,整条总线就会交叉卡死。
Simon Bullock 直接借用了 Andy Haas 开源的 KiCadRoutingTools 物理引擎做确定性兜底,把 LLM 的工作权限死死收窄在“总设计师下策略”这一步:
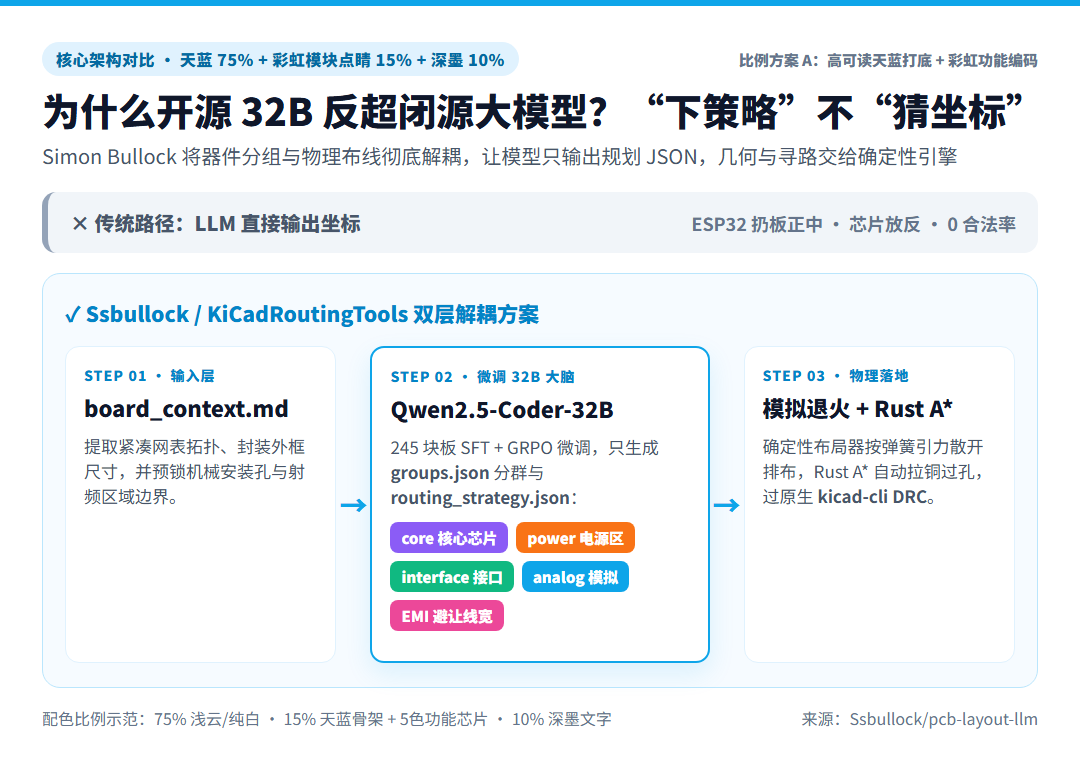
第一层是 输入层极简摘要(board_context.md),代码先从 KiCad 项目抽出紧凑的网表关系与封装几何边界,同时做机械锁位与射频模块检测。
第二层是 AI 只吐两份战略规划 JSON,微调后的 Qwen2.5-Coder-32B 不碰任何坐标数值,只输出 groups.json(一芯片一组的功能划分:core 核心、power 电源、interface 接口,指定锚点与邻近吸附关系)和 routing_strategy.json(地平面铺铜网络、EMI 隔离规则、电源走线分级、总线归并层与过孔约束)。
第三层是 确定性几何与 Rust 引擎收尾(gym_rollout.py),本地布局器按分群策略把器件先散开,再跑模拟退火算法(Simulated Annealing)压低线网交叉并清零重叠面积,最后交给 Rust A 自动布线器* 逐根拉线并送进原生 kicad-cli pcb drc 做规则卡点。
下面这段从项目实机运行视频提取的动图,完整记录了模块按功能分色聚类、退火排布、Rust 逐网拉铜以及翻面检查 3D 成板的完整过程:
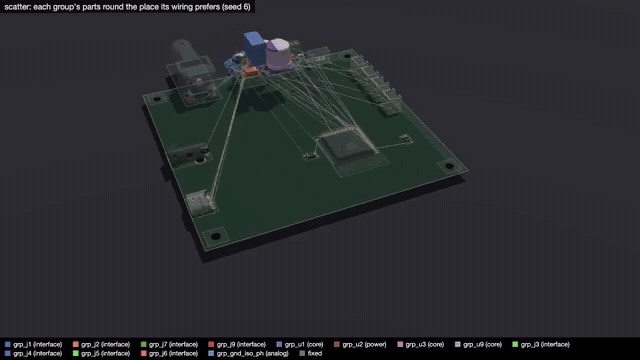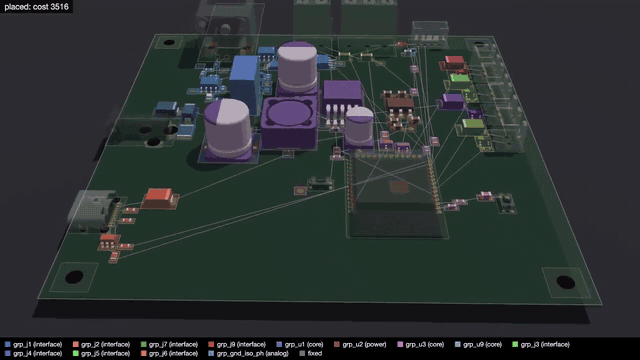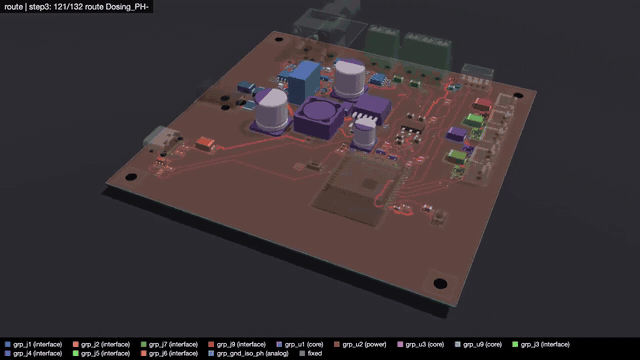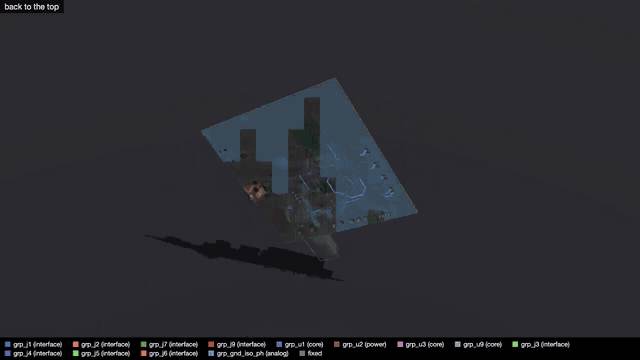
看明白这套分工就能理解为什么“微调小模型比闭源大模型快一倍”:未微调的原始 Qwen2.5-Coder-32B 一上手是 0/23(0%) 全灭,连合法策略结构都吐不出来;经过 245 块真板 训练后,格式合法率直接冲到 23/23(100%),每块板平均只需输出约 1,660 个 token,而 Claude Opus 5.5 要吐 ~2,800 个、Gemini 4 Carbon 约 4,400 个、GPT-6.1 Sol Pro 高达 ~6,500 个(相差最多 3.9 倍)。因为模块分组足够干净,后端 Rust A* 引擎不必反复撞墙回退,平均单板耗时从 Claude 的 118.1 秒 和 Gemini 的 98.8 秒 直接腰斩到 60.1 秒。
二、被忽略的胜负手:不是参数多大,是扔掉了37%的脏数据
Simon Bullock 在开源仓库 Ssbullock/pcb-layout-llm 和后续讨论里主动点破了一个比强化学习调参更关键的细节:数据清洗远比模型大小重要。
他最初收集了 393 块 开源 KiCad 电路板,没有全部丢进去微调,而是先用拒绝采样卡了一道严选过滤,整整淘汰掉 148 块 布线松散、结构残缺或规则不过关的样例,最终只留下 245 块 干净主板(拆成 214 条训练集、31 条验证集,外加 274 条 GRPO 在线优化提示)。
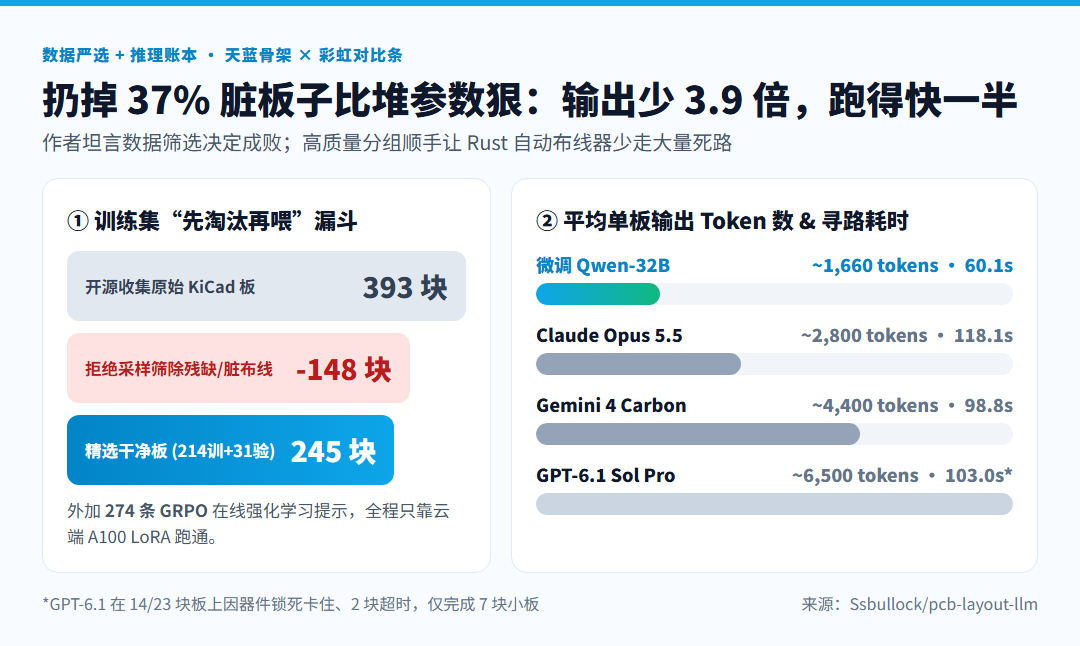
在这份盲测结果里还出现了一组反常识数据:对比原始人类开源参考板本身,开源作者原图在同样 kicad-cli 严格门禁下的零 DRC 通过率是 7/23(30%)、平均 DRC 报错 8.1 个、平均铜皮总长 1,522 mm、过孔 80.8 个;而微调 32B 跑出的成品把零 DRC 率推到了 11/23(48%)、平均错误降到 5.4 个、铜线长度缩到 1,468 mm、过孔少打到 64.7 个,按 19 项 John Teel 物理质量打分拿到 75.2 分(高于人类底图 73.8 分与 Gemini 73.2 分)。至于 GPT-6.1 Sol Pro,它在 14/23 块板 上直接触发 blocked_by_fixed_placement 卡死在固定器件冲突上、另有 2 块板超时,表面高达 80.6 分的均分实际只统计了勉强跑完的 7 块极简单小板。
三、想在真实工程里直接上手,先看清这3条真实边界
项目已经把全部训练脚本、23 板盲测集与 LoRA 权重开源放出(代码仓库 Ssbullock/pcb-layout-llm,模型权重 Simonssb/qwen2.5-coder-32b-pcb-grpo),如果准备自己装进 KiCad 9/10 测试,必须先认清作者与多位一线硬件工程师挑明的短板,避免直接拿去打样踩雷。
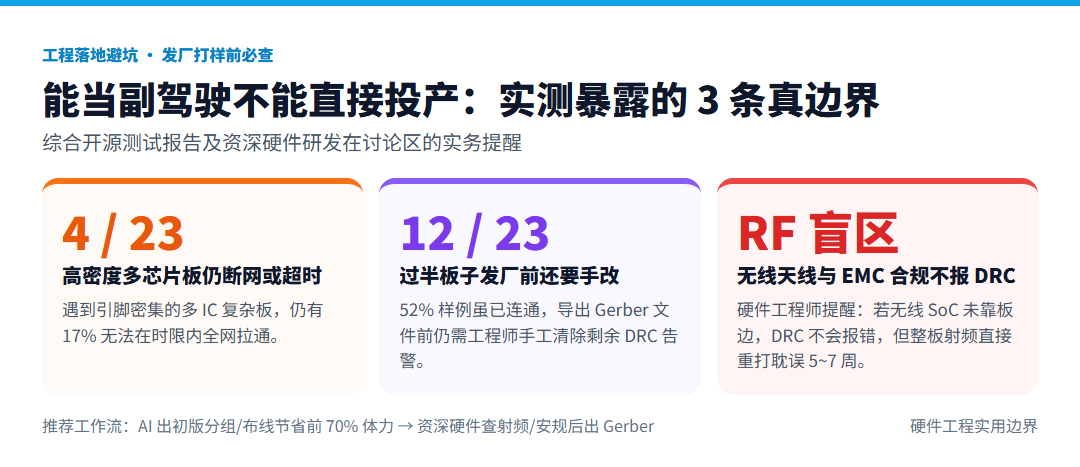
第一条边界是 高密度多 IC 板仍会超时或断网:在 23 块盲测板中,仍有 4 块(17%) 高密度复杂多芯片电路没能在时限内拉通所有网络。
第二条边界是 过半板子发厂前还要手改:虽然连通率做到 83%,但其中有 12/23 块 板子依然存在间距、丝印或铜皮警示,在导出 Gerber 生产文件前必须靠人工逐项修完 DRC 报错。
第三条边界是 DRC 查不出射频、合规与散热陷阱:公开技术讨论里两位资深硬件研发直接点出了更隐蔽的工程坑,即使通过了 DRC 规则,如果无线 SoC 天线摆在错误边界、走线紧贴高干扰源或缺少完整最终 Gerber 校验,射频与 EMC 合规测试会直接崩掉,往往意味着白浪费两版试制板预算和 5 到 7 周交付周期。
这套方案验证的核心不是“AI 明天就能替代硬件工程师”,而是垂类工程场景下的一条现实路线:用几百份经过严格挑拣的高质量工艺样例把 32B 开源小模型 练成专注规划策略的“副驾驶”,再把几何排布与布线约束还给确定性计算引擎。自己数据自己掌控、推理本地可跑通,这比把核心原理图源源不断喂给闭源云端按月交租实在得多。
常见问题
为什么微调后的 Qwen2.5-Coder-32B 在 KiCad 自动布线上能反超前沿闭源大模型?
核心在于把 AI 的权限卡死在战略规划层而不让它直接猜绝对 XY 坐标。微调模型只输出 groups.json(按 core、power、interface 分组的功能约束)与 routing_strategy.json(地平面、EMI 隔离、层分配与过孔约束),实际元件排布与走线全部交给确定性模拟退火算法和 Rust A* 自动布线引擎执行,避免了大模型直接生成数值坐标导致的偏移卡死。
245 块训练电路板和 23 块盲测板的真实跑分成绩是什么?
在 23 块全新盲测板上(含 21 块留出开源板与 2 块定制水培控制板),微调后 Qwen2.5-Coder-32B 取得 23/23(100%)合法输出、19/23(83%)全部网络连通与 11/23(48%)零 DRC 报错,平均耗时 60.1 秒、每板输出约 1,660 token;同期 Gemini 4 Carbon 为 70% 全连通和 39% 零 DRC,Claude Opus 5.5 为 65% 与 30%,GPT-6.1 Sol Pro 仅 30% 与 13%,而未微调的原始 32B 模型为 0/23。
为什么说扔掉 37% 的开源电路板样本反而是效果关键?
作者收集了 393 块公开 KiCad 电路板,通过拒绝采样淘汰了 148 块(约 37.7%)布线松散或残缺的脏样本,只保留 245 块规范设计用于训练与在线 GRPO 强化学习。正因为规则洁净,模型生成结果的 0-DRC 通过率达到 48%,甚至高于这 23 块人类开源原底图本身 30% 的 0-DRC 通过率,平均铜线总长与过孔数量也更紧凑。
这套开源工具目前适合直接拿去生成正式投产 PCB 吗?
不适合直接无人值守发厂投产。盲测暴露三条明确边界:第一,仍有 4/23(17%)的高密度多芯片电路会超时或断网;第二,12/23 块板在导出 Gerber 文件前仍需工程师手动修复残留 DRC 告警;第三,KiCad DRC 无法查出无线天线摆位、高干扰耦合与电磁兼容认证风险,发射射频或安规依然需要资深硬件研发逐项把关。
写春秋管理咨询 · 顾问直连(自 2005)
扫码领《同行业人效数据表 / 咨询签约核查单》
微信扫码添加写春秋顾问企业微信,发送「核查单」即可领取本文配套工具表。如企业已有明确改善计划,请直接留言「所在城市 + 行业 + 人数 + 当前卡点」,资深顾问本人对接。
自测工具: 97 家企业人效对标计算器 · 计件改计效与调薪保本测算 · 人效分位与咨询选型对照表
首席顾问:刘新珍(国防科大工程师出身 · 中国首位女性 ICMC 认证咨询师 · 20余年管理咨询经验) · 地址:深圳市光明区招商局光明科技园 B2-1402