行业观察
工厂里最便宜的视觉相机,盯螺丝孔位、外壳划痕这种固定外形其实很早就过关了;真正十几年没啃动的是**“手一动、件就变”**的工位。
铝箔撕开封口变成一大片、注塑件剪掉水口拆成三个散件、方钢框量完尺寸合装成型,只要物料在镜头下换了形状或者一分为二,大多数模型盯住的依然是第一帧记住的“老样子”。结果后面多出来哪几片、少没少装,追踪框当场就跟丢了。
康奈尔大学发表在 NeurIPS 2025 的开源系统 TubeletGraph(arXiv:2511.04678),第一次不用拿车间图片重头标注微调,就把物体变形拆分后的新轨迹重新“追了回来”,作者在正文 4.3 节也直接把它指向车间作业合规录像分析与机器人示教标注。为了不被论文的演示动画带偏节奏,写春秋管理咨询技术团队直接在工作站的 24GB NVIDIA RTX PRO 4000 Blackwell 上把开源代码完整跑了一遍,对比论文里的 48GB RTX A6000(约 7 秒/帧),把耗时、显存瓶颈、实测视频结果和工位管理账一次摊开。
以下对比中的车间作业情境仅用于说明制造现场管理痛点,不代表写春秋客户项目数据;开源复现基于官方仓库公开样例 0334_cut_fruit_1 完成,学术指标出自原论文正文与附录。
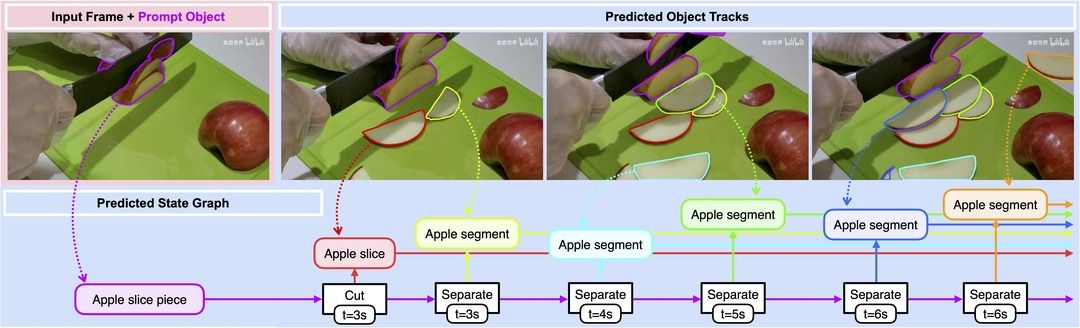
本机 RTX PRO 4000 Blackwell 实测:8.5 秒录像算近 13 分钟,显存顶到 97.7%
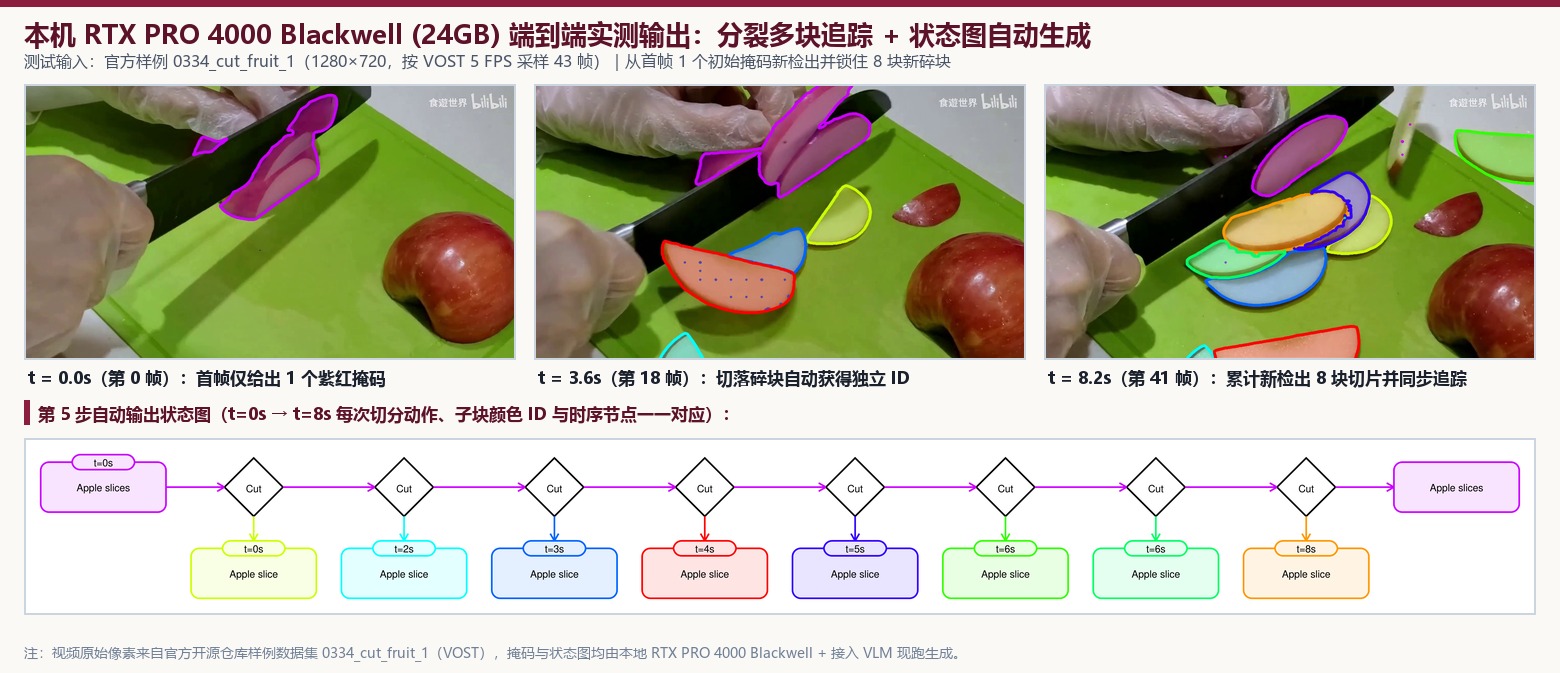
很多技术方案在推广时只讲“零样本多准”,很少把硬件门槛和算力账算到单帧。写春秋在自有工作站 WSL2 Ubuntu 22.04 环境(NVIDIA RTX PRO 4000 Blackwell 24GB / 145W,CUDA 12.8 原生 sm_120 编译 SAM2 / Detectron2 / CropFormer,PyTorch 2.7.0+cu128)下,取官方开源样例 0334_cut_fruit_1(分辨率 1280×720),按论文 VOST 数据集标准的 5 FPS 抽取完整 8.5 秒切分过程(共 43 帧),第 5 步接入多模态接口 doubao-seed-2-0-lite-260428 生成状态图,实测成绩直接出来了:
把整套流程拆到每一步的耗时和显存峰值,真正卡住算力脖子的并不是最后的大模型,而是第一步全画面提案:
| 流水线阶段(本机 RTX PRO 4000 Blackwell 24GB 实测,43 帧 @ 5 FPS) | 阶段耗时 | 单帧摊销 | GPU 峰值显存(增量) | 工程观察 |
|---|---|---|---|---|
| Step 1 · CropFormer (HorNet-3x) 全帧实体分割 | 432.18 秒 | 10.05 秒/帧 | 23,909 MiB(+22,671 MiB) | 占 24GB 显卡可用显存的 97.7%,功耗打满 148.9W,全链路头号瓶颈 |
| Step 2 · SAM2.1 (Hiera-Large) 时空小管追踪与补追 | 200.78 秒 | 4.67 秒/帧 | 4,752 MiB(+3,514 MiB) | 遇新露出的碎块需多次重初始化分段前向追踪 |
| Step 3 · FC-CLIP (ConvNeXt-Large) 热启动语义过滤 | 30.67 秒 | 0.71 秒/帧 | 3,961 MiB(+2,723 MiB) | 纯帧计算约 15 秒;首次冷启动含拉权重为 141.56 秒 |
| Step 4 · TubeletGraph 空间近邻与语义图融合 | 1.31 秒 | 0.03 秒/帧 | 1,419 MiB(+181 MiB) | 从首帧 1 个初始掩码中新增锁定 8 块被切出的独立切片 |
| GPU 前 4 步热跑小计(对比论文 A6000 约 7 秒/帧) | 664.94 秒 | 15.46 秒/帧 | 23.35 GiB | 若计入首次下载权重的冷启动共计 775.83 秒(18.04 秒/帧) |
| Step 5–6 · VLM 状态图 + 视频/PDF 渲染 | 96.15 秒 | 2.24 秒/帧 | CPU / API | VLM 调用 91.82 秒产出 8 步切分状态图 + 渲染 4.33 秒,全链路合计约 12.7 分钟 |
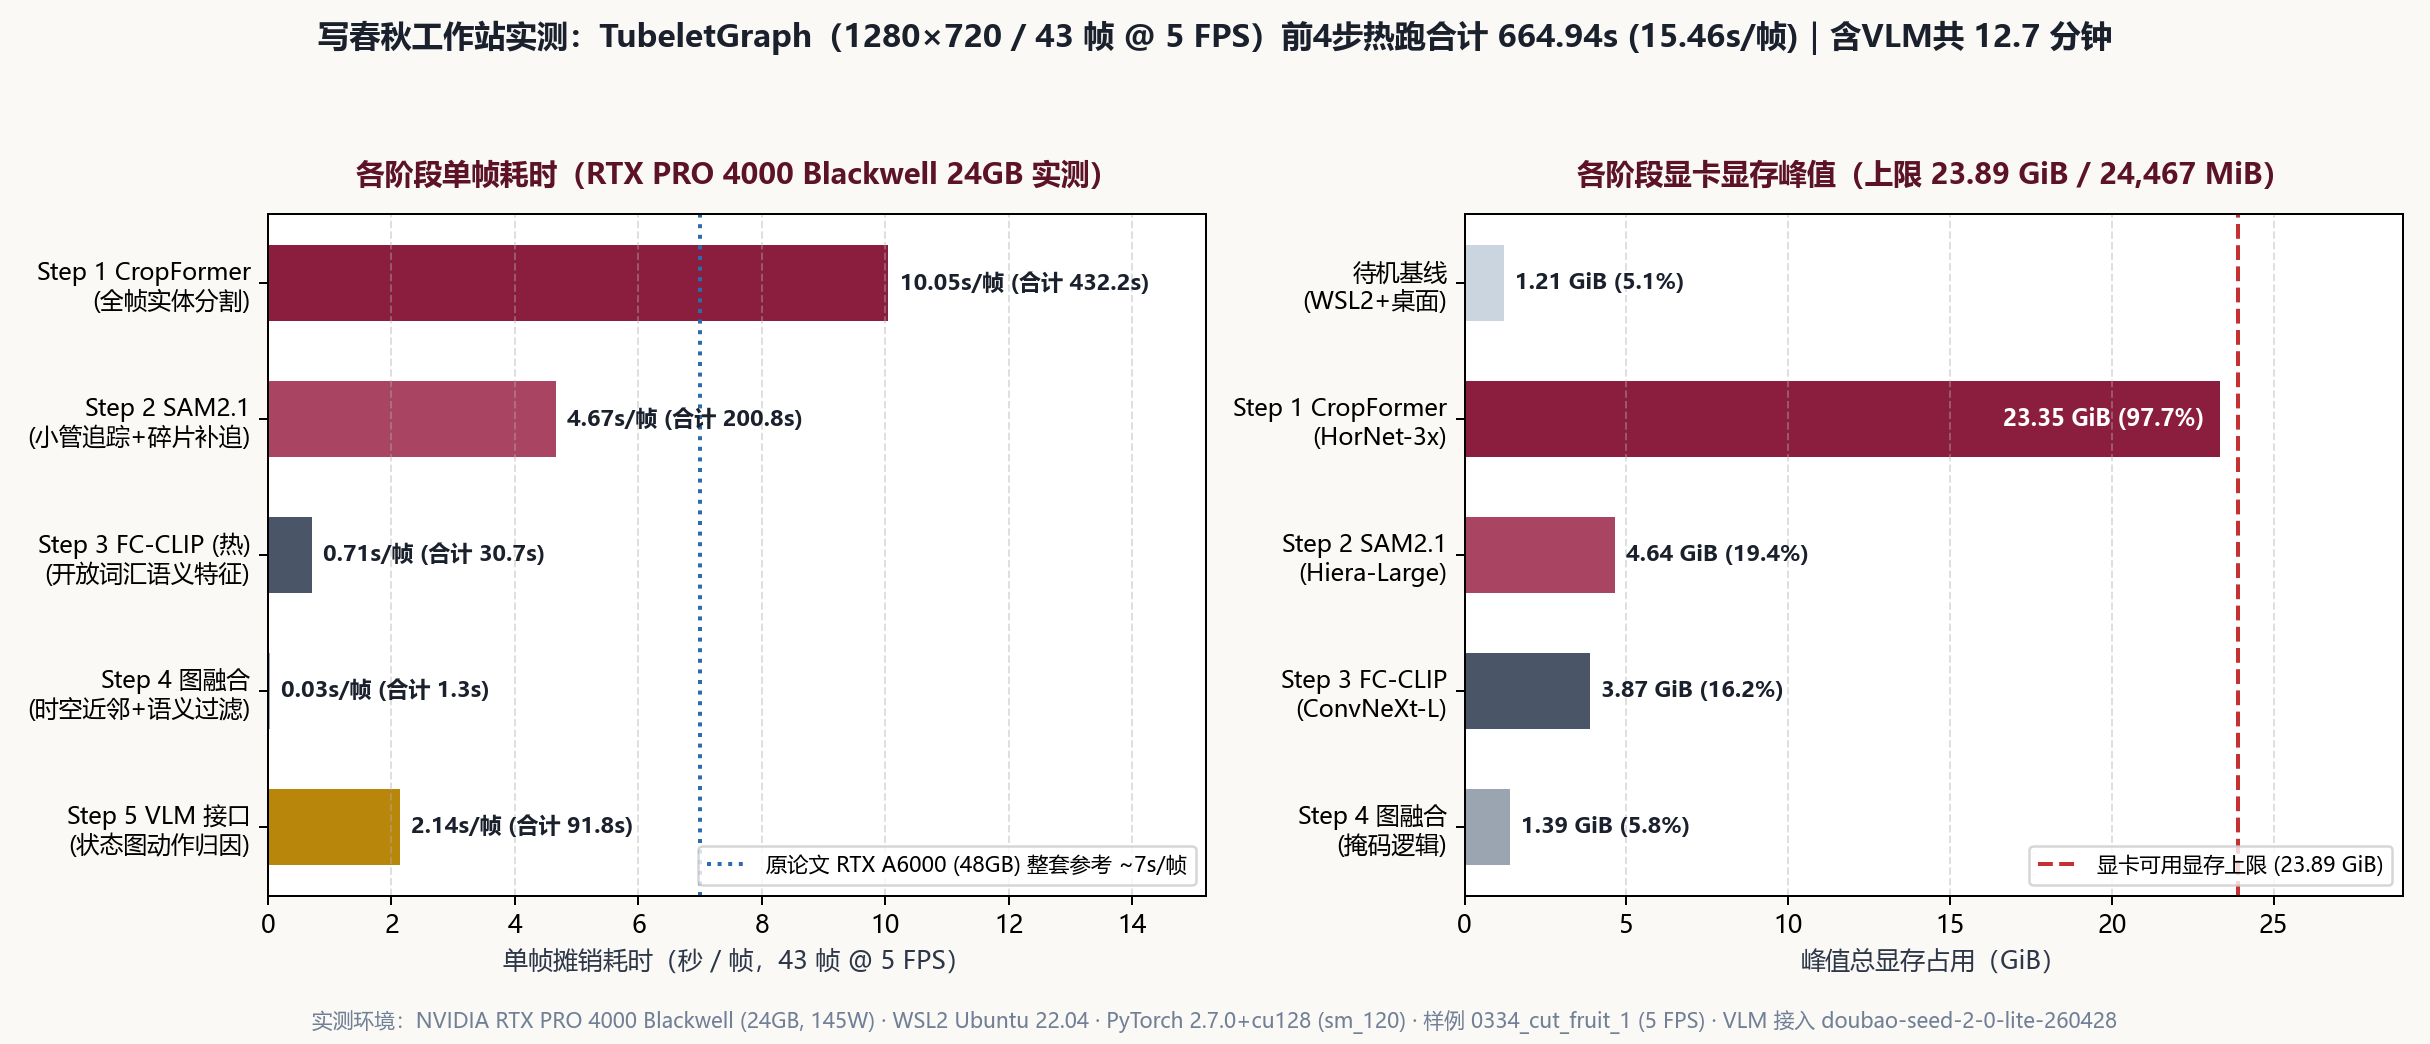
从输出帧和自动生成的状态图可以看到,TubeletGraph 的追踪稳定性确实有真本事:第 0 帧只框出刀下那一堆待切苹果切片,到第 18 帧和第 41 帧桌面陆续切出散落切片,系统自动把新切下的 8 块碎片一一赋予独立彩色编号并用状态图串起 t=0s → t=8s 的每一次 Cut 动作,同时没被旁边那半个不动的苹果带偏。但它也诚实地漏掉了桌面上两片刚翻出去的小果皮与立起薄片,而且 8.5 秒(43 帧)5 FPS 视频在 24GB 专业卡上仍要跑近 13 分钟(比实时播放慢近 90 倍),24GB 显存更是在 Step 1 就逼近撞墙。
论文原指标怎么看:跟踪更稳了,但端到端状态图总召回率仅 6.5%
把视角从单机算力拉回到算法准度。过去两类方案各有死角:以 SAM2 为首的视频分割模型只认外观相似性,物体破损分裂后后段漏检严重;直接问 GPT-4.1 这类多模态大模型“视频里干了什么”,它虽能说出语义结论,却没法把动作精确钉回画面里的某几个子部件轮廓与起始帧。
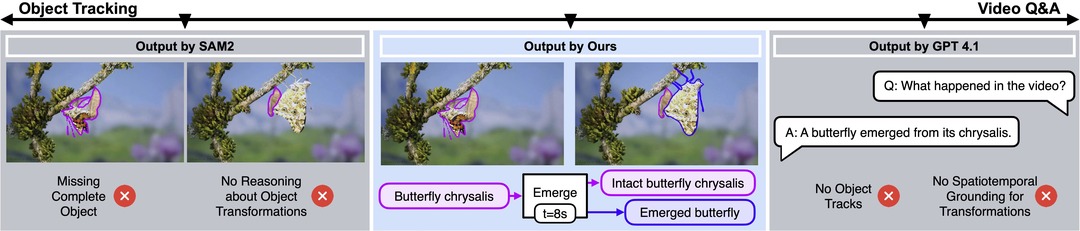
TubeletGraph 选择**零样本免微调(Training-free)**三步拼接:用 CropFormer + SAM2.1 对全画面区域建立时空管道(Tubelet),出现未覆盖的新像素块即补新轨;再用空间覆盖重叠率(阈值 0.3)和 FC-CLIP 语义相似度(阈值 0.7)剔除旁边晃过的无关工具或路人;最后只抽变化前后两帧圈色图给多模态模型生成状态图。
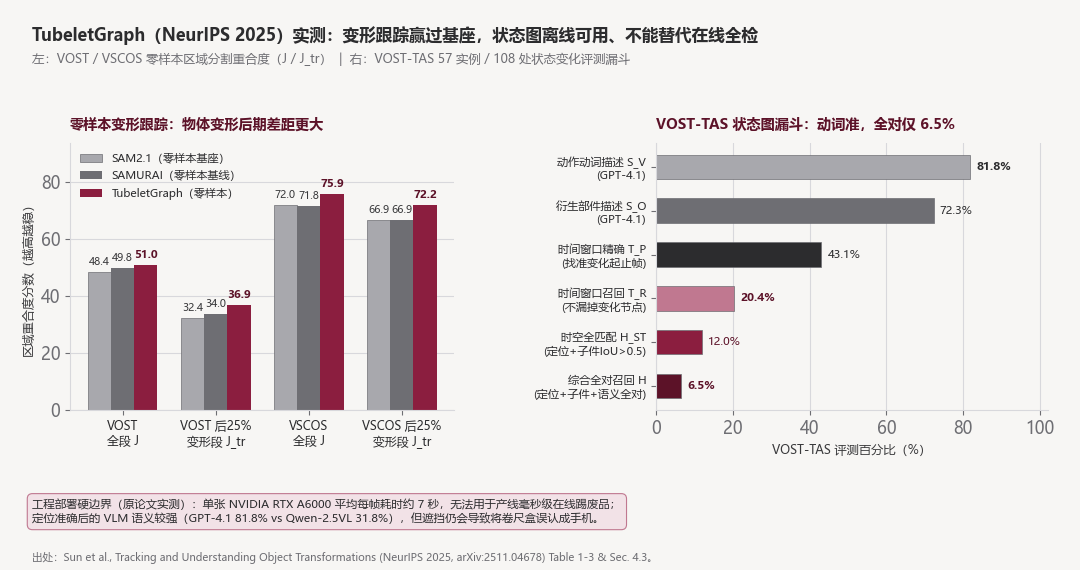
把论文 Table 1 至 Table 3 的原数据摊开看,能立刻打破对“零样本全自动”的幻想:
| 评测维度(NeurIPS 2025 arXiv:2511.04678) | SAM2.1 零样本 | TubeletGraph 零样本 | 工厂管理视角翻译 |
|---|---|---|---|
| VOST 全段重合度 J | 48.4 | 51.0 | +2.6(p=0.026),免标数据直接更稳 |
| VOST 后 25% 变形段 J_tr | 32.4 | 36.9 | 基座召回跌到 34.7% 时,新系统保住 47.2%(p=0.008) |
| VSCOS 全段 / 变形段 (J / J_tr) | 72.0 / 66.9 | 75.9 / 72.2 | 跨数据集通用稳定 |
| VOST-TAS 动作 / 产物语义准确率 | 暂无 | 81.8% / 72.3% | 找准帧后 GPT-4.1 语义较准;换 Qwen-2.5VL 降至 31.8% / 44.6% |
| VOST-TAS 时序查准 / 召回 (T_P / T_R) | 暂无 | 43.1% / 20.4% | 外观未显式分裂或新增块时被动机制易漏报 |
| VOST-TAS 综合全对总召回 H | 暂无 | 6.5% | 时空与描述全对率仍低,不可无人复核自动判废 |
| 推理成本参考 | 高速可用 | A6000 ~7s/帧;RTX PRO 4000 15.46s/帧 | 只能做离线录像抽检回溯,不能进实时高速线 |
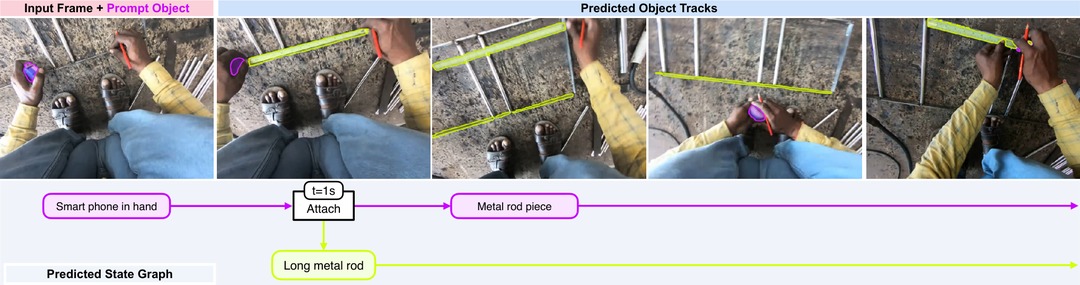
更值得车间负责人盯住的,是作者自己放进附录的那张翻车截图:五金工作台上工人左手拿卷尺量方钢框,拇指短暂挡住尺盒一秒,前端只切出半截塑料壳,后端大模型看完直接把它认成了“智能手机”,把拉出的尺带认成“长金属棒”,生造了一条“第 1 秒拼接部件”的假事件。
我算过这笔账:制造厂落“AI 看录像”的三个前置动作
我在珠三角车间陪跑复盘时,经常遇到老板一听供应商展示“零样本自动识别”就想立刻采购上线。在我看来,结合工作站实测显存顶到 97.7%、15.46 秒/帧 的推理代价加上 6.5% 的全对召回率,如果直接买一套号称“全自动盯车间”的视觉大系统塞上产线,不出半年多半会因为算力卡死、误报连连而被班组长关掉报警。写春秋管理咨询成立于 2005 年,总部位于深圳光明区,在深圳、东莞、佛山制造企业协助梳理工艺现场与绩效体系时,我更倾向于先帮企业卡住三条前置规矩,再谈 AI 录像试点:
第一,把“离线异常追溯”从“在线实时踢废”里剥离开。产线毫秒级良率判定依然交给成熟工业相机与光电传感器;TubeletGraph 这类状态图方案最贴合的场景,是客诉批次录像倒查、新产品试产 SOP 工步拆解留档、危险/防错工序合规抽检——这些环节不需要毫秒级卡死节拍,却能让品质员少翻几小时无头监控录像。
第二,先用 OSMP 把摄像头底下的工位清干净。技术跑得顺不顺,八成取决于现场物理环境。写春秋管理咨询进驻车间梳理作业与管理分工时,习惯先通过 OSMP 明确各工位物料周转盒、工具归位点、废料剥离框的物理边界:规定拆封或剪水口等关键状态变化必须停留在顶视或斜 45 度无手掌重遮挡区域内半秒,先把动作和工装摆标准,再上算法,卷尺才不会被认成手机。
第三,坚持“AI 捞疑点切片,班组长与工艺握终判权”并进量杯考核。把算法定位成“从 8 小时车间录像中自动捞出几十个可疑工步片段”的助手,最终质量认定、返工归因与班组改善,仍须由品质主管和工艺工程师复核,再接入量杯型 KPI 与立次方薪酬,让少返工、降客诉的改善成果和一线班组真实利益挂钩,系统才不会在车间沦为摆设。
十五分钟自检
本周复盘车间返工时,品质部有没有遇到“工序变形拆装后录像追溯不清、只能靠人肉眼拉几个小时进度条”的场景?如果同时连关键防错动作必须在镜头前停顿或暴露哪几个特征、异常切片由谁复核扣责都还没写进岗位卡,先补上这两条比急着上新系统更省钱。
论文基准出自康奈尔大学 arXiv:2511.04678(项目主页),工作站 GPU 实测基于官方开源代码在写春秋自有 NVIDIA RTX PRO 4000 Blackwell (24GB) 完成并完整保留原始采样口径。
延伸阅读与咨询入口
常见问题
TubeletGraph 论文解决了什么以前做不到的工业视觉难题?
康奈尔大学发表于 NeurIPS 2025 的 TubeletGraph(arXiv:2511.04678)针对物体发生切割、拆解、折弯或涂覆等状态变化(Track Any State)设计:通过 CropFormer+SAM2.1 构建全画面时空分块、用空间邻近(0.3)和 CLIP 语义(0.7)过滤衍生部件,再由 VLM 输出状态演化图。在 VOST 变形后期 J_tr 上零样本拿到 36.9,高于基座 SAM2.1 的 32.4(p=0.008)。
写春秋在实际 24GB 显卡工作站上复现 TubeletGraph 的实测耗时和显存怎样?
在写春秋自有工作站的 24GB NVIDIA RTX PRO 4000 Blackwell(WSL2、CUDA 12.8 原生 sm_120、PyTorch 2.7.0+cu128)上运行官方样例 0334_cut_fruit_1(1280×720,按 VOST 标准 5 FPS 共 43 帧、覆盖 8.5 秒完整切分视频),前 4 步 GPU 热跑合计 664.94 秒(15.46 秒/帧),其中第 1 步 CropFormer 独占 432.18 秒(10.05 秒/帧)且峰值显存达到 23,909 MiB / 24,467 MiB(占 97.7%);接入多模态 VLM 生成状态图耗时 91.82 秒、渲染耗时 4.33 秒,8.5 秒短视频端到端共约 12.7 分钟,且从首帧 1 个初始掩码新锁住 8 块切片。
这套方法能直接买回工厂产线做实时在线踢废品吗?
不能。原论文在 48GB RTX A6000 上平均约 7 秒/帧,我们在 24GB RTX PRO 4000 Blackwell 上热跑前 4 步约 15.46 秒/帧,均远低于产线毫秒级节拍;同时在 VOST-TAS 108 次状态变化评测中综合全对总召回率仅 6.5%,且手掌遮挡会让卷尺盒误认成智能手机,因此只适合离线作业合规复盘和客诉追溯。
写春秋管理咨询在推进制造业离线视觉复盘时解决哪一段卡点?
写春秋管理咨询成立于 2005 年,总部位于深圳光明区,驻厂时先帮制造企业用 OSMP 梳理岗位职责与无遮挡防错动作标准,再通过量杯型 KPI 把工艺复核、返工损耗和班组长考核对齐,并用立次方薪酬衔接改进收益,确保视觉软件接进车间后能跑通问责与改善。本文结合公开学术论文与开源样例本机基准测试撰写,不代表客户工厂项目数据。
写春秋管理咨询 · 顾问直连(自 2005)
扫码领《同行业人效数据表 / 咨询签约核查单》
微信扫码添加写春秋顾问企业微信,发送「核查单」即可领取本文配套工具表。如企业已有明确改善计划,请直接留言「所在城市 + 行业 + 人数 + 当前卡点」,资深顾问本人对接。
自测工具: 97 家企业人效对标计算器 · 计件改计效与调薪保本测算 · 人效分位与咨询选型对照表
首席顾问:刘新珍(国防科大工程师出身 · 中国首位女性 ICMC 认证咨询师 · 20余年管理咨询经验) · 地址:深圳市光明区招商局光明科技园 B2-1402