行业观察
做硬件开发、嵌入式、工控板卡的企业老板,最头疼的一件事是跨界人才凑不齐。懂 AI 算法的人看不懂时序约束和硬件描述语言,会写 Verilog 的十年老兵又不一定懂大模型推理的访存瓶颈。只要涉及 FPGA 或定制电路,研发主管默认就得按年立项、堆老专家、等动辄十几个小时一轮的时序仿真。
11 月 20 日,机器学习研究者 Ankit Gupta 公开了一份新实录。他大概十年没正经写过 C++,从来没学过也一行没写过 Verilog,只靠云端租按小时计费的 AWS FPGA 实例和编程 Agent 自动跑探索循环,前后烧掉约 1 万美元的模型调用额度,攒出约 300 万行实验代码、解析约 3000 万行日志,真的把开源推理模型 Maple 跑进了可编程芯片电路里。第一版能跑通、而且和服务器 CPU 逐比特算得一模一样时,速度是每秒 6.43 个词元(tok/s);跑完 14 轮自动迭代,速度直接推到每秒 213.13 个词元,翻了 33.13 倍,比同价位的 32 核 Zen 5 处理器还要快 1.65 倍。
为什么门外汉写出来的电路,能比 32 核 CPU 更快
把数字拆开看,这件事成立的前提不是大模型突然学会了造通用 GPU,而是题目刚好卡在了三值权重模型和可编程逻辑阵列的交界点上。
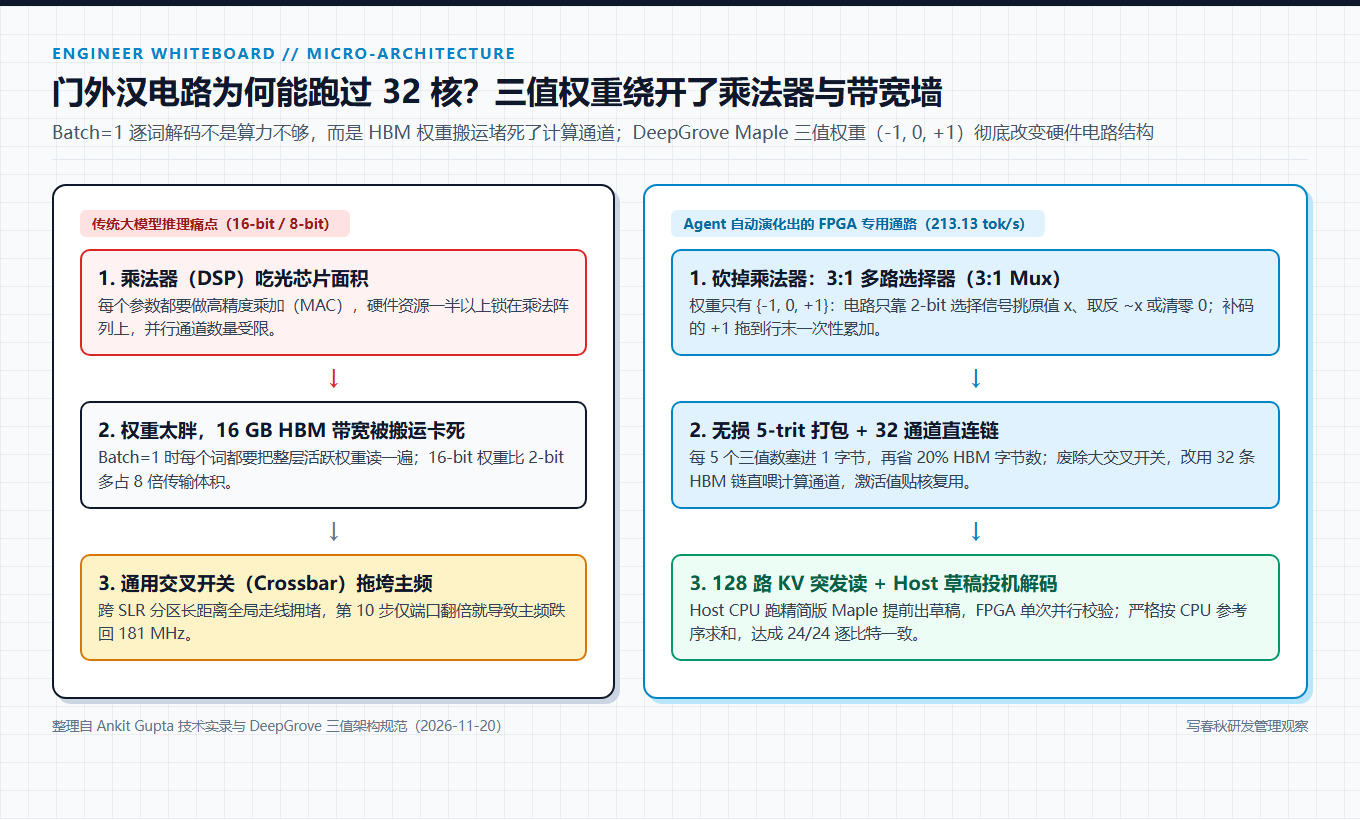
Ankit Gupta 挑中了 DeepGrove 团队做的三值权重混合专家模型 Maple,模型权重只有负 1、零、正 1 三个取值,开源版本约 5.31 GB,每次推理只激活少数专家。单用户逐字解码时,真正卡死芯片速度的根本不是乘法有多难算,而是每秒要把海量的权重参数和注意力缓存从高带宽内存(HBM)里搬出来。传统大模型权重占 16 位甚至 8 位,在单卡受限的 16 GB 内存带宽前,算力单元大部分时间都在干等数据送上门。
三值权重换成硬件电路后,最占资源的乘法器(DSP)直接退场了。每个权重只需要 2 个比特,用一个三选一多路选择器(3:1 mux)去挑原值、取反或者清零,取反缺的那一个加 1 也不用每个计算通道单独算,攒到每一行结束再统一累加。Agent 顺着这条物理特性继续往下挖,还把每 5 个三值数无损塞进 1 个字节里(5-trit packing),硬生生砍掉了 20% 的权重搬运体积,配合芯片的 32 条 HBM 内存通道做成每通道一根流水链,把带宽利用率拉满。
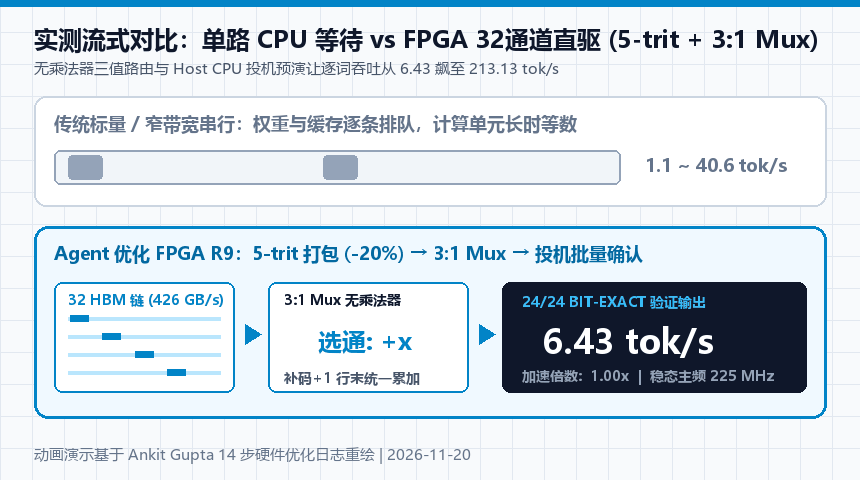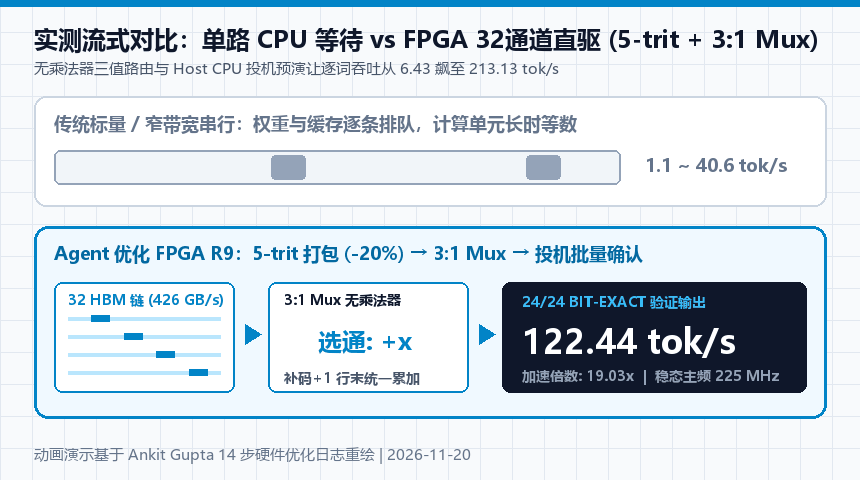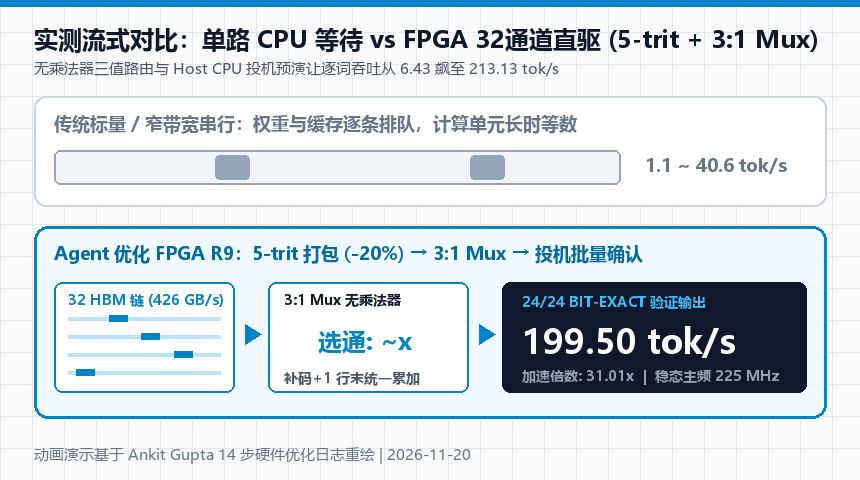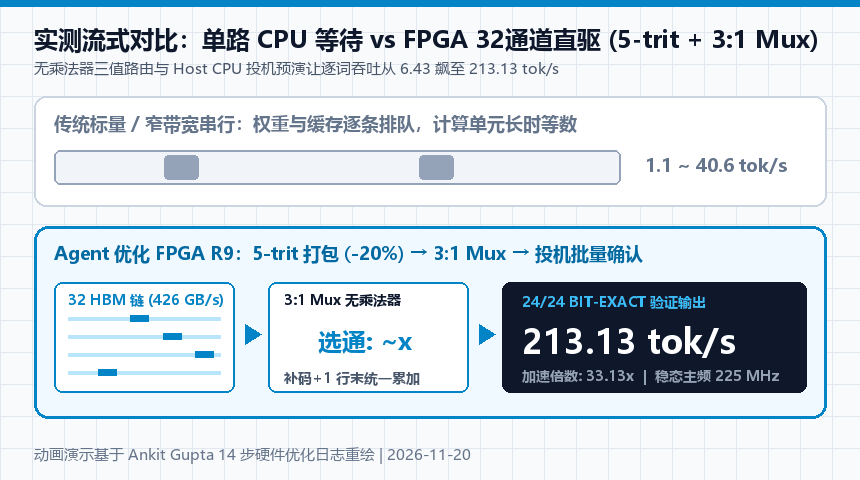
当然,最决定生死的并不是第一天就全看清,而是后面整整 166 次交互、14 个版本的死磕。Ankit Gupta 统计过,前面 67 条提示词甚至连一块能出数的硬件图像都没编出来,AI 先花大量时间申请云配额、搭交叉编译环境、写对拍测试脚本。直到第一个完整位精确版本 R8 上板跑通,只有 6.43 tok/s,比同一台主机上的多核 CPU 还慢,优化循环才算真正开跑:
第一步改宿主机驱动,把每次调用指令的额外开销从 10 毫秒压到 0.9 毫秒,速度升到 8.07 tok/s;第二步让 128 路注意力引擎突发批量读取 KV 缓存,跳到 14.02 tok/s;第三步并行化混合专家路由器、第四步把位置编码和归一化塞进专门的胶水并行引擎、第五步重做主控流水线并解决上板才暴露的两处硬件死锁,连续跳到 49.21 tok/s;第六至第九步引入投机解码,先用主机提示词猜、再让主机 CPU 跑精简版草稿模型提前写、FPGA 一次校验多个词,直接冲上 105.63 tok/s;第十一步到第十四步靠掩藏 KV 读取延迟、5-trit 打包搬出远端输出头缓解布线拥堵,外加内存双 bank 并行加载和专家预取,最终在 225 MHz 核心 / 425 MHz 内存频率下跑稳了 213.13 tok/s。
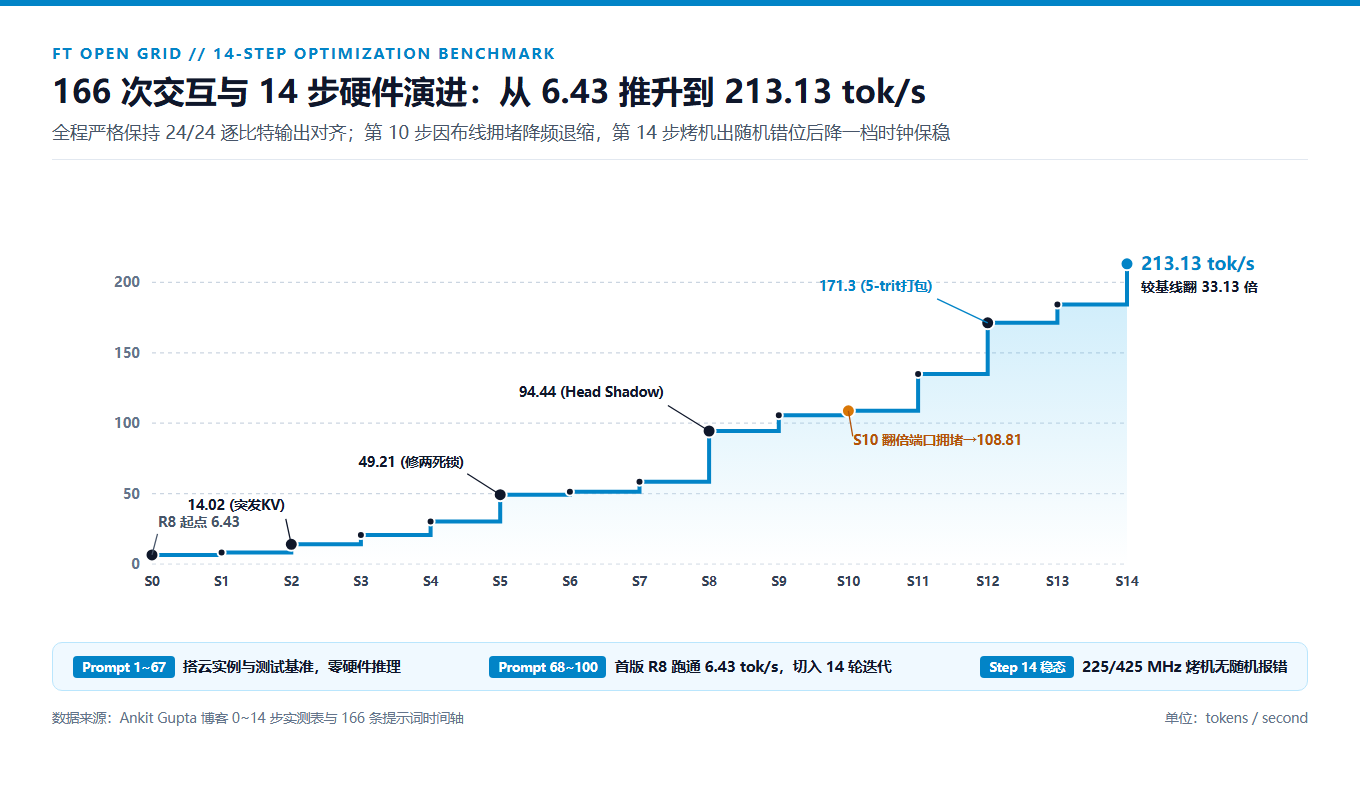
顺便说一句最能看出“工程诚实度”的插曲。第 10 步的时候,AI 试过把内存读取端口从 4 个直接翻倍到 8 个,理论每周期多干 39% 的活,结果 FPGA 芯片内部走线太挤导致主频被砍回 181 / 375 MHz,实际只微涨了 1.03 倍到 108.81 tok/s;第 14 步一开始跑到 231.25 MHz,做长稳烤机测试时却冒出了随机硬件错位,AI 自己乖乖降一档主频回 225 MHz 才交卷。这些走不通又退回来的折腾,恰好说明它跑的是真物理综合和真板卡时序,不是靠写手改数字编出来的捷径。
算一笔清醒的账:同价快 CPU 1.65 倍,日常生产为何仍多用显卡
如果文章写到这里收尾,很容易变成一篇鼓吹“硬件程序员马上失业”的爆款爽文。可把 Ankit Gupta 在 11 月 15 日跑出的同一组 8 轮对话共 24 组测试横向摆上桌,很多硬件研发经理最关心的冷冰冰现实立马就露出来了。
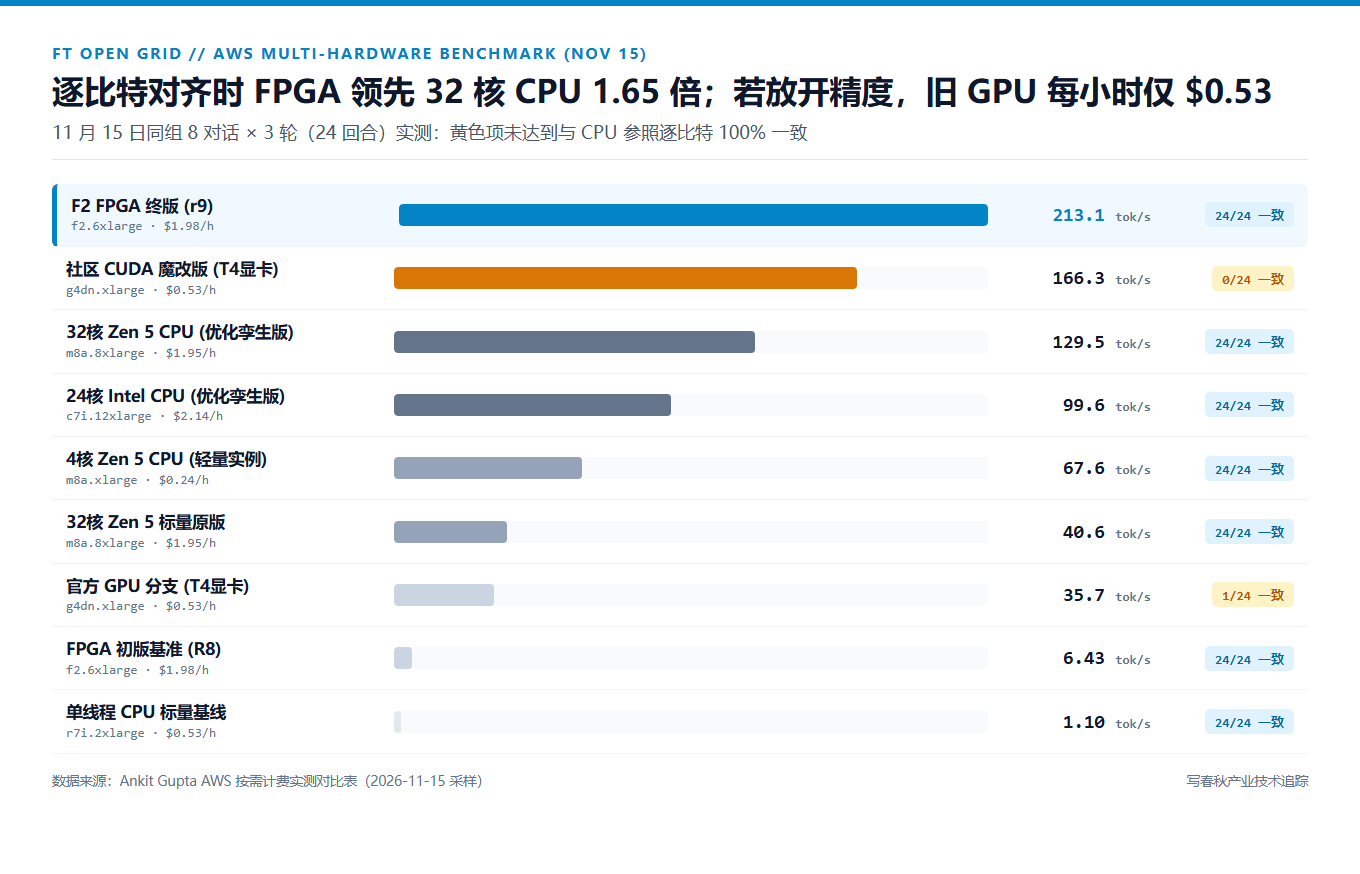
如果前提定死“输出每一个比特都必须跟 CPU 参考基准完全对得上(24/24 精确回合)”,这块每小时收费 1.98 美元的 AWS f2.6xlarge FPGA 实例拿到 213.13 tok/s,确实赢了几乎同价的 32 核 Zen 5 服务器 m8a.8xlarge(每小时 1.95 美元、129.5 tok/s,FPGA 快 1.65 倍),更赢过每小时 2.14 美元的 24 核芯片 c7i.12xlarge(99.6 tok/s)和 1.1 tok/s 的单核参照组。但表格最底下还有两行同样跑在同一张 T4 老显卡(g4dn.xlarge,每小时只要 0.53 美元)上的对照数:社区用 CUDA 硬改出来的版本,跑到了 166.3 tok/s。
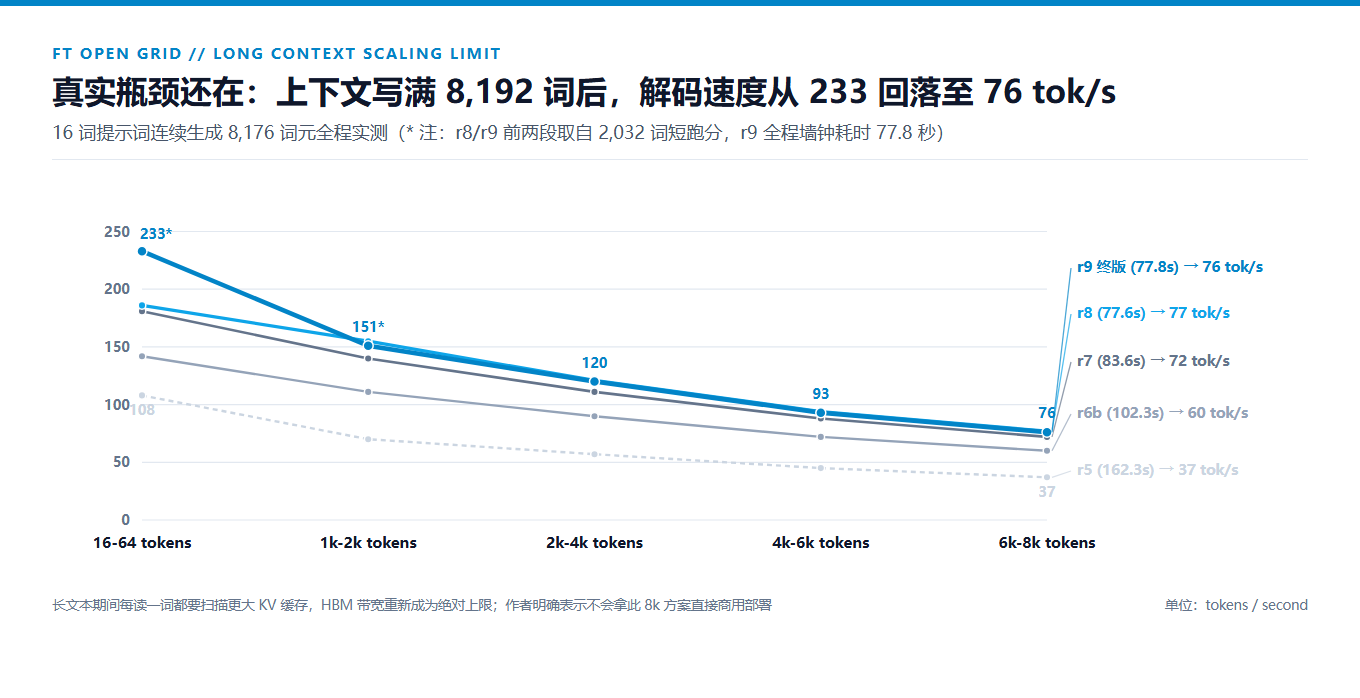
代价是,那张每小时 5 毛多美金的旧 T4 显卡,24/24 严格比特对齐率是 0/24(DeepGrove 官方 GPU 分支也只有 1/24,35.7 tok/s)。这恰恰帮制造业和技术管理者拆穿了真假需求:真正做工业产品发布时,只要允许轻微浮点舍入差异,现成成熟显卡的单位美元算力依然划算得多;再加上这套 FPGA 设计跑满 8,192 长上下文之后,因为内存带宽被拉满,最后 6k 到 8k 区间速度会从短文本的 233 tok/s 回落到 76 tok/s,作者自己在文末也明说不会直接拿这套 8k 方案去上生产,实验期间单模型推理验证就烧掉了约 1 万美元代币账单,目前也没有公开完整可下载硬件源码。
老专家的“秘籍”,为什么不如老板改“研发节奏”
全篇最值得每一家制造、半导体、嵌入式软件公司的管理层反复读的,反而是作者中途找 DeepGrove 团队求助的一段自查复盘。
当速度卡在每秒 10 个词左右上不去时,Ankit Gupta 给懂行的 DeepGrove 创始人发了条消息。对方非常惊讶,因为他们几个月前试过让模型写同类硬件没能走通,顺手发来了一份足足 4,741 字符的“FPGA 极致优化实战笔记”,里面详细拆了无乘法器三选一、KV 八比特量化、跨三个物理区域(SLR)怎么放计算单元、逻辑深度怎么控在 10 级以内、以及用完整周期仿真做逐层对拍的整套内行手艺。
Ankit Gupta 把整段秘籍原封不动复制进对话框。事后项目做完,他让 Agent 倒翻全部三千万行日志文件查证到底哪几条起了大作用,结果出人意料。Agent 在收到文档 70 秒内把建议拆成了 10 条采纳和 5 条拒绝:头一件事,文档里最核心的三条微架构点子(直接从 HBM 流式喂进计算单元、并行按行算、突发读 KV 缓存),Agent 早在拿到笔记之前 35 到 40 分钟就已经自己写进规划方案了;另一边,老手笔记里用来飙极限速度的 5 个低精度捷径(降激活精度、延迟归一化、8 比特 KV 缓存、在线柔和归一化、16 比特概率),因为全都会轻微改变输出比特,被 Agent 以“违背老板定下的逐比特一致合同”为由一条不留全部驳回。
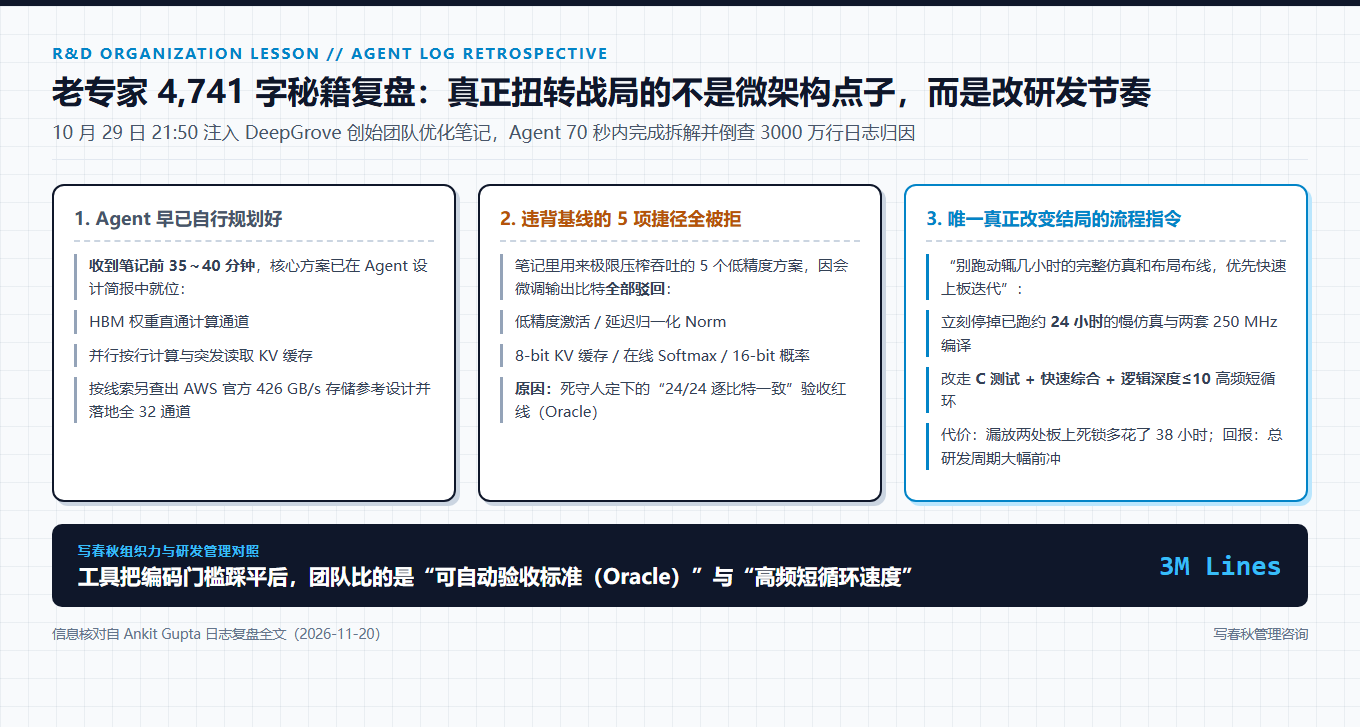
真正立刻把进度盘活的,反而是人工笔记里不起眼的一句“别去跑动辄几小时的周期精确仿真和完整布局布线,先拿短链路测试”。Agent 看到这句话,当场掐掉一个已经跑了大概 24 小时的重型仿真和两套 250 MHz 编译,全线切成先做 C 语言单测、再走快速综合、只卡逻辑深度门禁的高频短循环,外加自己检索 AWS 官方存储参考设计摸到了 426 GB/s 的全通道跑法。哪怕短循环漏放了两个只有靠全尺寸 RTL 仿真才抓得出的死锁,让集成那天多赔进去 38 小时排障,总体迭代速度依然把整个研发周期往前拽了一大截。
这正是深圳不少硬件、机电与制造业公司正在撞上的同一堵墙。写春秋管理咨询在给大型硬科技和制造企业做研发组织力诊断时常看到,老板一遇到卡点,本能反应都是花高价去外面挖一个十年资深专家、或者买一套更贵的经验流程手册挂在墙上,却很少审视团队手里有没有两样基础设施:第一,机器可以直接判对错的铁验收标准(Oracle),让 AI 或新人改完一步就知道算没算偏、越没越界,就像作者死守的那条 24/24 逐比特比对合同;第二,把动辄几周才能等出结果的验证长链切碎成几十分钟一轮的短反馈节拍,既让工具敢试错,又不至于彻底失控。
Ankit Gupta 用 1 万美元成本验证了一件事:当“不会写 Verilog”的语法壁垒被模型踩平以后,人真正值钱的动作只剩两个,一个是定清什么是绝对正确,另一个是规定用多快的节拍去逼近它。在写春秋看来,未来研发团队之间拉开差距的,早已不是谁背得熟几句老工种的行话,而是哪家公司的组织制度最先把经验变成可自动检验的标准、把漫长等待拆成机器吃得下的短循环。
信息整理自 Ankit Gupta 个人技术博客 2026 年 11 月 20 日公开实录及 DeepGrove 公开模型资料,文内基准测试与硬件耗费均源自原文实测数据,不涉及任何未公开第三方案例。
常见问题
完全不会 Verilog 的开发者,凭什么用 AI 跑出的 FPGA 推理电路能反超 32 核 Zen 5 处理器?
关键在于把三值权重 {-1, 0, +1} 模型结构贴合进可编程芯片的物理特性。由于 Batch=1 逐词解码瓶颈全在 HBM 带宽搬运而非算力,2-bit 三选一多路选择器(3:1 mux)直接取消硬件乘法器,配合 5-trit 打包减少 20% 权重传输字节、32 条直连 HBM 流水链、128 路 KV 突发读以及主机草稿投机校验,最终 14 步迭代把 24/24 逐比特一致的速度从 6.43 推到 213.13 tok/s(比同价 m8a.8xlarge 快 1.65 倍)。
这项实测是否意味着研发团队马上可以用 FPGA 全面替代 GPU 显卡?
还远不到全面替代阶段。作者同场测试明确列出:一旦取消 24/24 逐比特严苛对齐合同,每小时 $0.53 的旧 T4 GPU(g4dn.xlarge)社区 CUDA 版本已能跑出 166.3 tok/s(0/24 严格对齐),美元性价比远高于 $1.98/h 的 AWS F2 FPGA;且上下文跑满 8,192 词元后,r9 终版速度会回落至 76 tok/s,作者明确声明不会用这套 8K 方案直接上生产。
为什么团队请老专家写来 4,741 字秘籍,反而被 Agent 拒绝了 5 条?
事后检索三千万行日志证实,微架构主力方案(HBM 直通与突发读)Agent 在收到秘籍前 35 至 40 分钟就已自行写出;笔记里靠降精度换高吞吐的 5 项技巧,全因会改动输出比特而被 Agent 按既定逐比特合同当场驳回。真正立即拉快节奏的是人工提示先停掉 24 小时慢仿真、改为 C 单测与快速综合短循环的流程指令。
从写春秋管理咨询的角度看,这对制造业与硬科技研发团队有何启示?
当工具逐渐拉平跨专业编程语法门槛后,研发组织拉开差距靠两项底座制度:第一是建立像 24/24 逐比特对齐那样机器可自动判对错的验收标准(Oracle),不靠事后拍脑袋争论;第二是把按周等待的大型仿真验证拆碎成几十分钟一轮的短循环节拍,既兜住底线又换出十倍探索频率。
写春秋管理咨询 · 顾问直连(自 2005)
扫码领《同行业人效数据表 / 咨询签约核查单》
微信扫码添加写春秋顾问企业微信,发送「核查单」即可领取本文配套工具表。如企业已有明确改善计划,请直接留言「所在城市 + 行业 + 人数 + 当前卡点」,资深顾问本人对接。
自测工具: 97 家企业人效对标计算器 · 计件改计效与调薪保本测算 · 人效分位与咨询选型对照表
首席顾问:刘新珍(国防科大工程师出身 · 中国首位女性 ICMC 认证咨询师 · 20余年管理咨询经验) · 地址:深圳市光明区招商局光明科技园 B2-1402